Gemini 3.8 Live Extended Thinking et le Contexte Caching : Les Nouveaux Leviers d'Efficacité Agentique dans Google Workspace
Les toutes dernières avancées de Google avec Gemini 3.8 Live Extended Thinking et l'intégration profonde du Context Caching transforment l'approche des agents d'entreprise dans Google Workspace. Nous décryptons comment ces innovations redéfinissent la productivité, la latence et les coûts, offrant une nouvelle dimension à l'orchestration agentique. C'est une étape critique pour les déploiements IA à grande échelle.
En tant que Head of Product chez Astoïk, ma veille technologique est constante, surtout quand Google annonce des évolutions qui impactent directement nos architectures d'agents. Ces dernières 48 heures, l'actualité autour de Gemini 3.8 Live Extended Thinking et les raffinements du Context Caching dans l'écosystème Google Cloud sont particulièrement frappantes. Nous parlons ici d'une véritable accélération pour l'intégration d'agents IA dans les workflows d'entreprise, notamment via Google Workspace, et cela change la donne sur des points cruciaux comme les coûts et la performance.
L'enjeu est simple : rendre les agents IA non seulement plus intelligents, mais surtout plus utilisables et économiquement viables à l'échelle. Google répond à cette problématique avec des mises à jour qui ne sont pas de simples itérations, mais des mouvements stratégiques profonds.
Gemini 3.8 Live Extended Thinking : La Révolution Agentique en Voix et Vision
Le lancement de Gemini 3.8 Live et, plus spécifiquement, de sa variante Extended Thinking, le 15 septembre 2026, avec des mises à jour continues jusqu'à fin septembre, marque une étape majeure pour les interactions homme-machine. Ce n'est pas qu'une question de vitesse de parole ou de reconnaissance vocale ; c'est une question de capacité à raisonner en temps réel, de manière multimodale, et à orchestrer des tâches complexes sans rompre le fil de la conversation.
La version 3.8 Live est déjà impressionnante par sa fluidité. Elle gère des dialogues en temps réel avec un ancrage visuel quasi instantané, bascule automatiquement entre 97 langues, et exécute des outils ou des appels API en arrière-plan sans interrompre l'utilisateur. C'est fondamental pour des scénarios où la réactivité est clé, comme le support client ou l'assistance en direct.
Le Raisonnement Parallèle pour des Agents Plus Autonomes
Mais la véritable innovation pour nos déploiements chez Astoïk, c'est Gemini 3.8 Live Extended Thinking. Ce modèle introduit une capacité de 'pause et raisonnement'. Face à des problèmes complexes en plusieurs étapes, l'agent prend le temps de décomposer la tâche, d'effectuer des calculs intermédiaires, et même de narrer sa progression à voix haute, tout en maintenant la conversation. Imaginez un agent qui vous aide à planifier un voyage complexe, en énonçant ses étapes de recherche et de vérification. Cela rend l'IA beaucoup plus transparente et collaborative. Nous avons d'ailleurs déjà exploré ces dynamiques d'agents visuels et de raisonnement étendu dans nos articles récents, comme Gemini 3.8 Live et l'Avènement des Agents Visuels ou encore Gemini 3.8 Live et Extended Thinking dans Google Workspace : Une Révolution Agentique en Marche.
Les démonstrations sont éloquentes. On voit des agents transformer des croquis vocaux en composants React fonctionnels, coordonner des réservations de restaurant en plusieurs étapes via des appels de fonction asynchrones, et travailler de manière transversale sur Docs Live, Gmail Live et Keep Live au sein de Google Workspace. Pour nous, qui construisons des agents décisionnels pour les entreprises, c'est la promesse d'une automatisation bien plus sophistiquée et moins sujette aux ruptures.
Le Contexte Caching : Le Levier Économique et Technique Indispensable
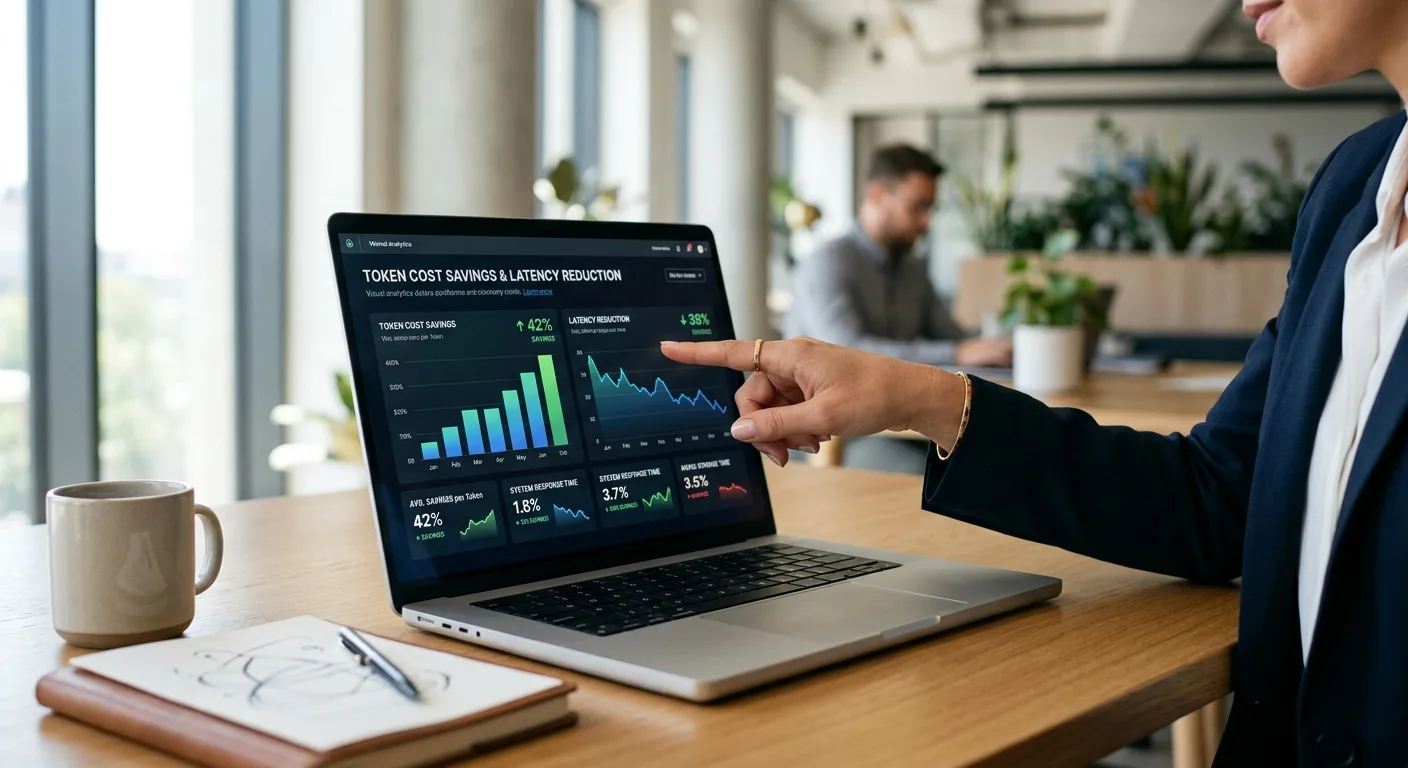
L'intelligence des modèles comme Gemini 3.8 Extended Thinking est une chose, mais leur coût et leur latence en production en sont une autre. C'est là que le Context Caching, dont les améliorations et la généralisation ont été mises en avant récemment, devient un élément absolument stratégique. Lancé initialement en 2024 et continuellement amélioré, ce mécanisme permet de réduire drastiquement les coûts des tokens d'entrée – jusqu'à 90% sur les tokens mis en cache – et d'améliorer la latence des requêtes API Gemini.
Le principe est simple mais puissant. Plutôt que de renvoyer l'intégralité d'un contexte statique (instructions système massives, corpus RAG, historique de conversation) à chaque requête, le Context Caching permet de stocker et de réutiliser des jetons précalculés. Cela évite au modèle de retraiter les mêmes informations à chaque tour de conversation ou à chaque nouvelle interaction. C'est une bénédiction pour des cas d'usage comme les chatbots de support client qui doivent toujours se référer à une documentation produit volumineuse, l'analyse de code, ou l'interrogation de vastes ensembles de documents.
Cache Implicite vs. Cache Explicite : Une Flexibilité Cruciale
Google propose deux saveurs de caching. Le cache implicite est activé par défaut et offre des réductions de coûts automatiques lors des 'cache hits'. C'est une optimisation transparente qui fonctionne bien pour des préfixes de requêtes similaires envoyées sur une courte période. Pour nous, ingénieurs, cela signifie moins de code à écrire pour bénéficier d'une meilleure efficacité. Le cache explicite, lui, offre un contrôle plus granulaire. Nous pouvons déclarer spécifiquement le contenu à mettre en cache et y faire référence dans nos prompts, garantissant ainsi des économies prévisibles. Cette granularité est essentielle pour des architectures d'agents complexes où nous gérons des bases de connaissances spécifiques ou des personas détaillés.
La capacité de cacher du contenu multimodal (texte, PDF, images, audio, vidéo) est également un atout majeur. Nos agents d'entreprise traitent de plus en plus de données hétérogènes, et pouvoir optimiser les coûts sur toutes ces modalités est un avantage concurrentiel non négligeable. Cela s'intègre parfaitement avec la plateforme Gemini Enterprise Agent, qui est l'évolution de Vertex AI.
Maîtrise des Coûts : Une Priorité Stratégique pour les Déploiements d'Agents
L'une des préoccupations majeures lors du déploiement d'agents IA en entreprise est la gestion des coûts. Les workloads agentiques sont souvent imprévisibles, avec des pics de consommation de calcul et de tokens qui rendent les budgets traditionnels obsolètes. Google Cloud a répondu à cette problématique avec l'annonce, le 25 septembre 2026, de nouvelles capacités de gestion de la facturation et des coûts, spécifiquement pour les agents IA fonctionnant sur Gemini Enterprise et la Gemini Enterprise Agent Platform.
Ces nouveautés incluent des options de paiement à l'usage, des plans d'épargne flexibles offrant des réductions de 10 à 20% sur les coûts des tokens pour un engagement mensuel, et une couche de gouvernance native dans la console de facturation Google Cloud. Cette dernière intègre la détection d'anomalies, des plafonds de dépenses par projet, et même un agent FinOps IA pour des résumés de coûts en langage naturel. C'est un pas de géant vers une responsabilisation financière des agents IA, ce qui est absolument essentiel pour nos clients PME qui surveillent chaque euro dépensé.
Le problème n'est pas le prix en soi, mais son imprévisibilité. Un agent multi-étapes peut consommer des quantités de tokens très variables selon la longueur du contexte, les appels de récupération RAG, et les invocations d'outils. Les modèles d'abonnement pur créent des 'quota cliffs', et les modèles de consommation pure peuvent entraîner des factures surprises. Google propose une solution hybride, alliant la prévisibilité d'un prix par siège pour l'accès de base à la flexibilité du paiement à l'usage pour les pics d'activité, sans bloquer les tâches en cours de route. Les plafonds de dépenses par projet, avec des alertes et des pauses automatiques des appels API, sont une fonctionnalité que nous attendions avec impatience pour maîtriser nos déploiements.
Retours Terrain chez Astoïk : Intégration et Défis Actuels
Chez Astoïk, nous intégrons déjà activement ces innovations dans nos architectures d'agents. L'arrivée de Gemini 3.8 Live Extended Thinking, couplée aux optimisations du Context Caching, nous permet de repousser les limites de ce que nos agents peuvent accomplir pour nos clients. Nous avons pu constater une amélioration notable de la latence sur les requêtes à contexte long, ce qui est critique pour des agents qui interagissent avec des bases de données vectorielles comme Pinecone ou Redis, ou qui orchestrent des workflows complexes sur des systèmes comme PostgreSQL ou Firestore.
Sur nos déploiements, nous observons que l'utilisation combinée du cache explicite pour les instructions système et du cache implicite pour les fragments de conversation répétitifs offre le meilleur ratio performance/coût. La gestion des clés de cache et leur invalidation est un point d'attention, car une stratégie de cache mal pensée peut entraîner des données obsolètes ou, paradoxalement, une augmentation des coûts si les cache misses sont trop fréquents. C'est un équilibre délicat que nous affinons en continu.
L'intégration de ces modèles dans Google Workspace via les API Gemini est de plus en plus mature, mais elle n'est pas sans défis. La complexité de l'orchestration agentique, où plusieurs agents spécialisés peuvent interagir, demande une architecture robuste. Le raisonnement étendu de 3.8 Live Extended Thinking, par exemple, ouvre des portes pour des agents plus autonomes, mais nécessite de repenser la manière dont nous gérons les retours utilisateurs et les points de contrôle dans nos workflows. C'est pourquoi nous avons souvent mis l'accent sur ces sujets, notamment dans notre article Google Workspace et Gemini 3.8 Live : L'Ère de l'Orchestration Agentique Redéfinit nos Workflows.
Perspectives et Prochaines Étapes
Ces récentes mises à jour de Google sont une confirmation claire de l'orientation vers des agents IA plus autonomes, plus efficaces et plus intégrés dans l'environnement de travail quotidien. Pour Astoïk, cela signifie une opportunité sans précédent de construire des solutions encore plus performantes pour nos clients. Nous allons continuer d'expérimenter avec le Context Caching pour des applications RAG massives, en explorant les limites des 1 million de tokens de la fenêtre contextuelle de Gemini 2.5 Pro (et au-delà pour les futures versions).
La capacité à 'penser' en parallèle et à narrer sa progression, comme le fait Extended Thinking, va transformer la perception et l'acceptation des agents IA par les utilisateurs finaux. C'est un pas vers une collaboration plus naturelle et intuitive avec l'intelligence artificielle. Les contrôles de coûts, quant à eux, sont la clé pour passer du pilote à la production à grande échelle, en offrant la prévisibilité financière que les entreprises exigent.
Notre prochaine étape sera de documenter des cas d'usage concrets où ces améliorations génèrent des ROI mesurables, en particulier pour les PME. Le potentiel de réduction des coûts d'inférence locale grâce à des modèles comme DeepSeek-V4.1-Flash, que nous avons analysé dans DeepSeek-V4.1-Flash : L'Analyse Post-Lancement Qui Bouleverse l'Inférence Locale et l'Agentique d'Entreprise, combiné aux optimisations cloud de Google, offre une feuille de route passionnante pour l'avenir de l'agentique d'entreprise.
Besoin d'avancer sur ce sujet ?
Discutons de vos enjeux spécifiques lors d'un audit informel.
Lou Chardin
Head of Product
Conçoit les architectures de données et les OS métiers IA d'Astoïk. Passionné par l'intégration pratique de l'IA générative.
Profil LinkedIn