
DeepSeek-V4.1-Flash-1017 : La Réduction Drastique du KV Cache Redéfinit l'Inférence Locale Agentique
L'écosystème de l'IA open source ne cesse de nous surprendre. La mise à jour DeepSeek-V4.1-Flash-1017 vient de bouleverser la donne pour l'inférence locale, notamment grâce à une compression inédite du KV cache. Nous analysons ici les implications concrètes pour nos déploiements et la course à l'efficacité des modèles agentiques.
DeepSeek-V4.1-Flash-1017 : L'Étape Manquante pour une Inférence Locale Vraiment Frugale ?
L'actualité de l'IA, c'est un flux constant. Pour nous, chez Astoïk, la veille est un sport de combat. On cherche le signal fort, celui qui va réellement changer notre approche sur le terrain. La dernière étincelle ? La mise à jour DeepSeek-V4.1-Flash, estampillée '1017'. Ce n'est pas un nouveau modèle, mais une révision de leur Flash existant, sortie le 17 octobre 2026, qui fait déjà grand bruit sur les forums techniques. La promesse est simple : plus d'intelligence, un coût d'exécution drastiquement réduit et une efficacité matérielle inédite, particulièrement pour les workloads agentiques. C'est exactement le genre de nouvelle qui capte notre attention, car elle touche directement les problématiques de coût et de déploiement que nous rencontrons avec nos clients PME.
Pendant des mois, nous avons vu DeepSeek-V4.1-Flash s'imposer comme un acteur clé de l'inférence locale. Nos propres analyses, comme DeepSeek-V4.1-Flash-1017 : Un Coup de Tonnerre pour l'Inférence Locale Agentique, ont déjà souligné son potentiel. Mais cette révision '1017' va plus loin. Elle s'attaque à un nerf de la guerre : la gestion de la mémoire, et plus précisément le KV cache. C'est là que réside la vraie innovation des dernières 48 heures.
La révolution du KV Cache : Moins de HBM, moins de SSD
Le 'KV cache', pour Key-Value cache, c'est la mémoire tampon qui stocke les états d'attention des tokens précédents dans une séquence. Pour les modèles à long contexte, et DeepSeek-V4.1-Flash gère un contexte d'un million de tokens, ce cache peut devenir un goulet d'étranglement colossal en termes de consommation mémoire. Plus le contexte est long, plus le KV cache est gourmand. Et qui dit gourmandise mémoire, dit besoin en HBM (High Bandwidth Memory) et SSD, des ressources coûteuses.
Avec cette mise à jour 1017, DeepSeek annonce avoir significativement réduit les besoins en hardware pour son KV cache. La nouvelle version n'utiliserait qu'un quart de la mémoire HBM et seulement un huitième du stockage SSD par rapport à la version précédente de V4.1 Flash. C'est un chiffre qui nous a fait lever un sourcil. Concrètement, cela signifie que pour chaque entrée de token, le modèle ne consomme plus que 890 octets. Une telle optimisation change la donne pour le déploiement. Moins de VRAM nécessaire sur les GPU, moins de dépendance à des SSD ultrarapides pour le offloading du cache persistant, cela se traduit directement par une baisse des coûts d'infrastructure. Pour des déploiements locaux ou sur des machines avec des ressources plus limitées, c'est une bénédiction.
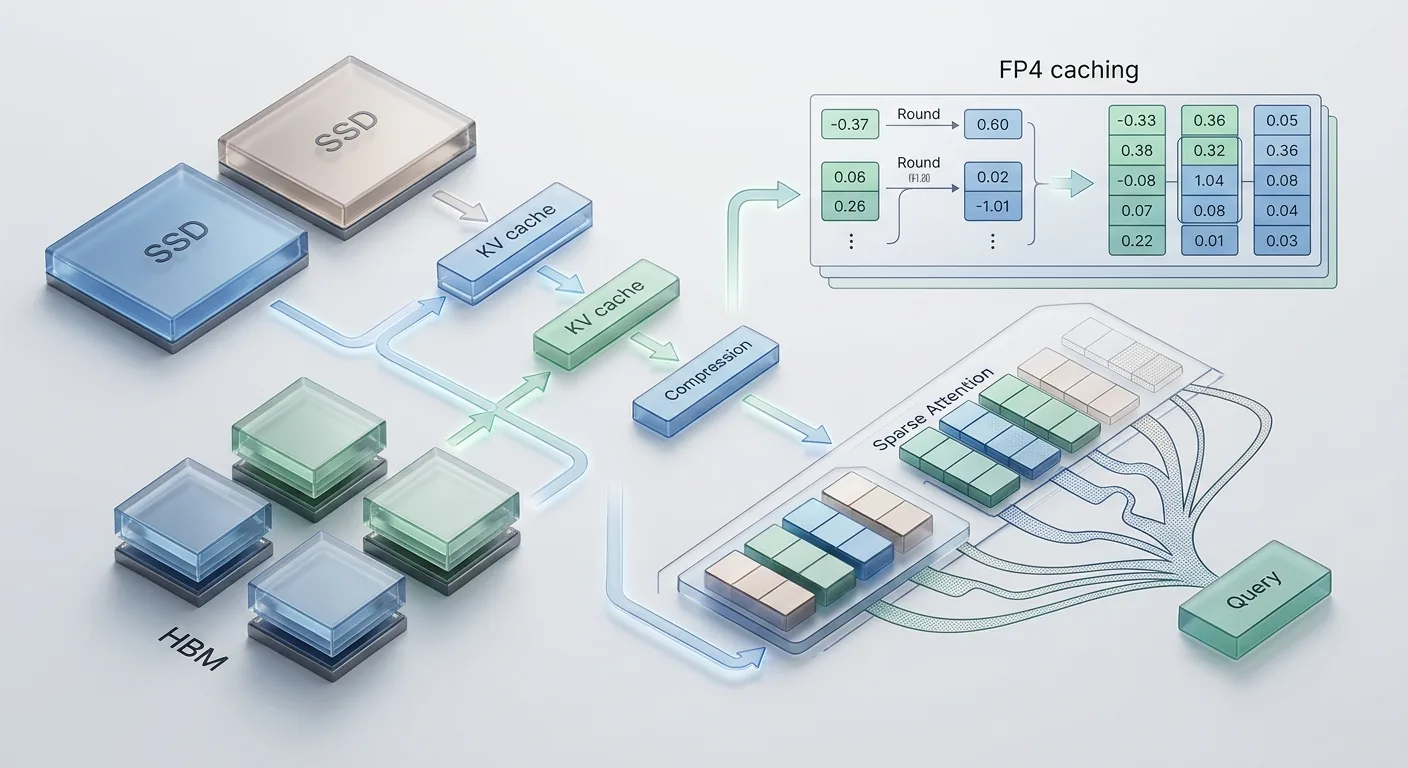
Techniquement, DeepSeek-V4.1-Flash exploite une architecture Mixture-of-Experts (MoE) avec 552 milliards de paramètres au total, mais seulement 16 milliards sont actifs pendant la génération et 8 milliards pendant le pré-remplissage. Cette asymétrie, combinée à des techniques de compression avancées comme le Compressed Sparse Attention 2 (CSA2) et le caching FP4, est la clé de cette frugalité mémoire. Ils ont également introduit une optimisation de déploiement appelée SWA Bounded Replay qui réduit l'empreinte du KV cache persistant sur SSD. C'est une prouesse d'ingénierie qui nous permet d'envisager des architectures plus légères pour les agents autonomes.
DeepSeek-V4.1-Flash-1017 sur les benchmarks agentiques : Promesses et limites
Au-delà de l'efficacité matérielle, ce qui nous intéresse, ce sont les performances réelles, surtout sur les tâches agentiques. DeepSeek positionne son V4.1-Flash-1017 comme un modèle capable de 'wish-driven programming', c'est-à-dire de gérer des tâches complexes et ouvertes. Selon leurs benchmarks internes, le modèle se placerait entre GPT-5.6 Sol et Claude Opus 5, surpassant même Anthropic sur certains tests. Il excelle particulièrement en efficacité par tâche et en optimisation des tokens générés, avec des sorties plus courtes et des temps d'exécution réduits.
Sur DeepSWE, un benchmark qui évalue la capacité à résoudre des problèmes de code réels, DeepSeek-V4.1-Flash-1017 affiche un score de 77.0%, dépassant Claude Opus 5 (74.0%) et GPT-5.6 Sol (73.0%). Sur Terminal-Bench 4.0, qui teste les opérations en ligne de commande et les tâches multi-étapes, il a fait un bond de 31.2 à 42.3. Ce sont des scores impressionnants pour un modèle open-weight.
Cependant, il faut rester nuancé. Ces résultats sont basés sur les benchmarks internes de DeepSeek. D'autres classements, comme l'Artificial Analysis Intelligence Index, placent DeepSeek-V4.1-Flash-1017 un peu plus bas dans la catégorie open-weight, avec un score de 45, loin derrière un Claude Opus 5.5 qui atteint 58. La prudence est de mise. Ce que nous observons, c'est que DeepSeek excelle dans les tâches de code et d'agent qui récompensent l'utilisation d'outils et l'exécution en plusieurs étapes, mais il peut traîner un peu sur les benchmarks de raisonnement pur où les modèles propriétaires plus grands conservent un avantage. Et un point crucial : le modèle reste 'hallucination-prone', surtout sur les workloads agentiques. C'est un risque que nous devons gérer activement dans nos déploiements.
L'intégration dans nos architectures : Ollama et vLLM en première ligne
Chez Astoïk, l'intégration de modèles comme DeepSeek-V4.1-Flash est au cœur de nos réflexions. L'objectif est clair : tirer parti des avantages de l'open source tout en maîtrisant les coûts et la souveraineté des données. Pour cela, des outils comme Ollama et vLLM sont essentiels. Ils nous permettent de déployer ces modèles localement, sur nos infrastructures ou celles de nos clients, avec une flexibilité maximale.
La compatibilité de DeepSeek-V4.1-Flash avec vLLM est un atout majeur. vLLM offre une optimisation du débit d'inférence, ce qui est crucial pour les applications d'agents autonomes qui nécessitent des réponses rapides et un traitement de nombreuses requêtes. DeepSeek a même publié de nouveaux kernels optimisés pour vLLM, améliorant le débit agentique jusqu'à cinq fois depuis la sortie initiale du modèle. C'est ce type de collaboration et d'optimisation que nous cherchons activement. Nous avons d'ailleurs exploré ce 'triptyque' en détail dans notre article Ollama, DeepSeek-V4.1-Flash et vLLM : Le Triptyque Qui Redéfinit l'Inférence Locale Agentique.
Ollama, de son côté, simplifie grandement le déploiement de DeepSeek-V4.1-Flash sur des environnements plus légers, y compris des postes de travail. C'est une passerelle importante pour l'expérimentation et les cas d'usage où une API cloud n'est pas envisageable. Pouvoir prototyper rapidement avec un modèle puissant et efficace en local, c'est un gain de temps et d'argent considérable pour nos équipes et pour nos clients qui veulent tester avant d'investir massivement.
Nos retours terrain et la feuille de route pour les agents d'entreprise
Chez Astoïk, nous ne nous contentons pas de lire les benchmarks. Nous mettons les mains dans le cambouis. Ce que nous retenons de cette mise à jour 1017, c'est l'accélération d'une tendance forte : l'optimisation des coûts d'inférence pour les modèles open source. La capacité à réduire l'empreinte mémoire du KV cache est un game changer pour l'exécution d'agents à long contexte. Imaginez des agents qui parcourent des milliers de documents pour synthétiser des informations, générer des rapports ou automatiser des workflows complexes. Le coût par token et la latence sont des métriques critiques. DeepSeek-V4.1-Flash-1017 nous donne de nouveaux leviers pour les améliorer.
Cependant, la question des hallucinations reste centrale. Pour les tâches où la précision est absolue (intégration ERP, gestion financière), nous continuons à privilégier des architectures hybrides, combinant des modèles plus robustes pour les décisions critiques et des modèles open source comme DeepSeek-V4.1-Flash pour la génération de texte, la compréhension contextuelle et les tâches moins sensibles. L'orchestration multi-agents, avec des boucles de vérification et des appels API à des systèmes externes fiables, est plus que jamais notre credo.
Nous voyons cette évolution comme une opportunité d'étendre nos déploiements d'agents autonomes. Avec des coûts d'inférence réduits, il devient plus viable de construire des systèmes multi-agents qui interagissent sur de très longues périodes sans faire exploser la facture. Cela ouvre la porte à des automatisations plus profondes et plus intelligentes pour des secteurs comme la logistique, la finance ou le service client, où la capacité à traiter un grand volume d'informations contextuelles est primordiale.
Conclusion : Une avancée concrète pour l'IA open source en entreprise
La mise à jour DeepSeek-V4.1-Flash-1017 n'est pas une révolution conceptuelle, mais une optimisation technique majeure qui a des répercussions très concrètes. Elle nous montre que la course à l'efficacité est loin d'être terminée dans l'IA open source. Pour nous, intégrateurs et architectes, c'est une excellente nouvelle. Cela signifie plus de puissance à moindre coût, et la possibilité de pousser encore plus loin les limites de ce que l'on peut faire avec l'IA appliquée en entreprise. C'est un pas de plus vers des systèmes d'IA plus autonomes, plus performants et surtout, plus accessibles.
Nous continuons à suivre de près ces évolutions et à partager nos retours d'expérience. Le terrain, c'est là que la vraie valeur se crée, et DeepSeek-V4.1-Flash-1017 nous donne de nouveaux outils pour y arriver.
Besoin d'avancer sur ce sujet ?
Discutons de vos enjeux spécifiques lors d'un audit informel.
Lou Chardin
Head of Product
Conçoit les architectures de données et les OS métiers IA d'Astoïk. Passionné par l'intégration pratique de l'IA générative.
Profil LinkedIn