
DeepSeek-V4.1-Flash : L'Analyse Post-Lancement Qui Bouleverse l'Inférence Locale et l'Agentique d'Entreprise
Chez Astoïk, nous scrutons chaque nouvelle avancée qui peut transformer nos architectures. La publication récente par Kie.ai d'une analyse approfondie du DeepSeek-V4.1-Flash, datée du 1er octobre, confirme ce que nous pressentions : ce modèle multimodal redéfinit les attentes en matière d'inférence locale et de déploiement d'agents. Son efficacité et ses performances bousculent le marché, rendant l'IA de pointe accessible pour des cas d'usage critiques en entreprise.
L'actualité IA est un flux incessant. Chaque jour, un nouveau modèle, un benchmark inédit, une optimisation algorithmique. Mais parfois, une annonce, même si elle date de quelques semaines, prend une nouvelle dimension avec des analyses complémentaires. C'est exactement ce qui se passe avec le DeepSeek-V4.1-Flash. Lancé officiellement le 10 septembre dernier, ce modèle a déjà fait couler beaucoup d'encre. Mais la dernière revue détaillée de Kie.ai, publiée aujourd'hui même, le 1er octobre, met en lumière des aspects cruciaux qui changent la donne pour nos déploiements en entreprise.
Nous l'avons dit à plusieurs reprises, notamment dans notre article DeepSeek-V4.1-Flash : L'Open Source Redéfinit l'Inférence Locale et L'Agentique – Le Vrai V5 Déguisé ?, DeepSeek-V4.1-Flash n'est pas un LLM comme les autres. Il a été conçu avec une obsession pour l'efficacité et la performance, en particulier pour les tâches agentiques. Les données fraîchement compilées par Kie.ai, qui incluent des détails sur son API et sa structure de coûts, confirment que nous sommes face à un titan de l'open source, capable de rivaliser avec des modèles propriétaires bien plus lourds.
Une Architecture Révolutionnaire pour l'Inférence Locale
Ce qui distingue le DeepSeek-V4.1-Flash, c'est son approche architecturale novatrice. Nous parlons ici d'un modèle multimodal Mixture-of-Experts (MoE) de 552 milliards de paramètres, avec une fenêtre contextuelle impressionnante d'un million de tokens. Ce n'est pas juste un chiffre, c'est une capacité à ingérer des volumes massifs de données, essentielle pour des agents autonomes qui naviguent dans des environnements complexes, comme l'analyse de documents longs ou de bases de code complètes.
Mais la vraie magie opère avec son architecture Causal Encoder-Decoder (CED). Concrètement, cela signifie que seulement 8 milliards de paramètres sont actifs par token en entrée et 16 milliards par token en sortie. Cette ingénierie permet une efficacité coût-performance spectaculaire. Sur nos machines, cela se traduit par une consommation de mémoire VRAM nettement réduite et des temps d'inférence qui nous permettent d'envisager des déploiements locaux auparavant impensables. Pour les PME, c'est une aubaine. Finis les coûts d'API exorbitants pour des boucles d'agents intensives.
L'innovation ne s'arrête pas là. DeepSeek a intégré des techniques comme le SWA Bounded Replay et le Compressed Sparse Attention 2 (CSA2), qui réduisent drastiquement l'empreinte de la mémoire KV cache à seulement 890 octets par token. Sur le terrain, cela signifie une gestion bien plus fine du cache, un point critique pour les agents qui doivent maintenir un état et un contexte sur de longues interactions. C'est un gain direct sur les coûts de calcul, surtout quand on sait que les charges de cache-hit peuvent représenter une part significative du budget d'un agent.
L'Inférence Locale avec vLLM et Ollama : Une Synergie Puissante
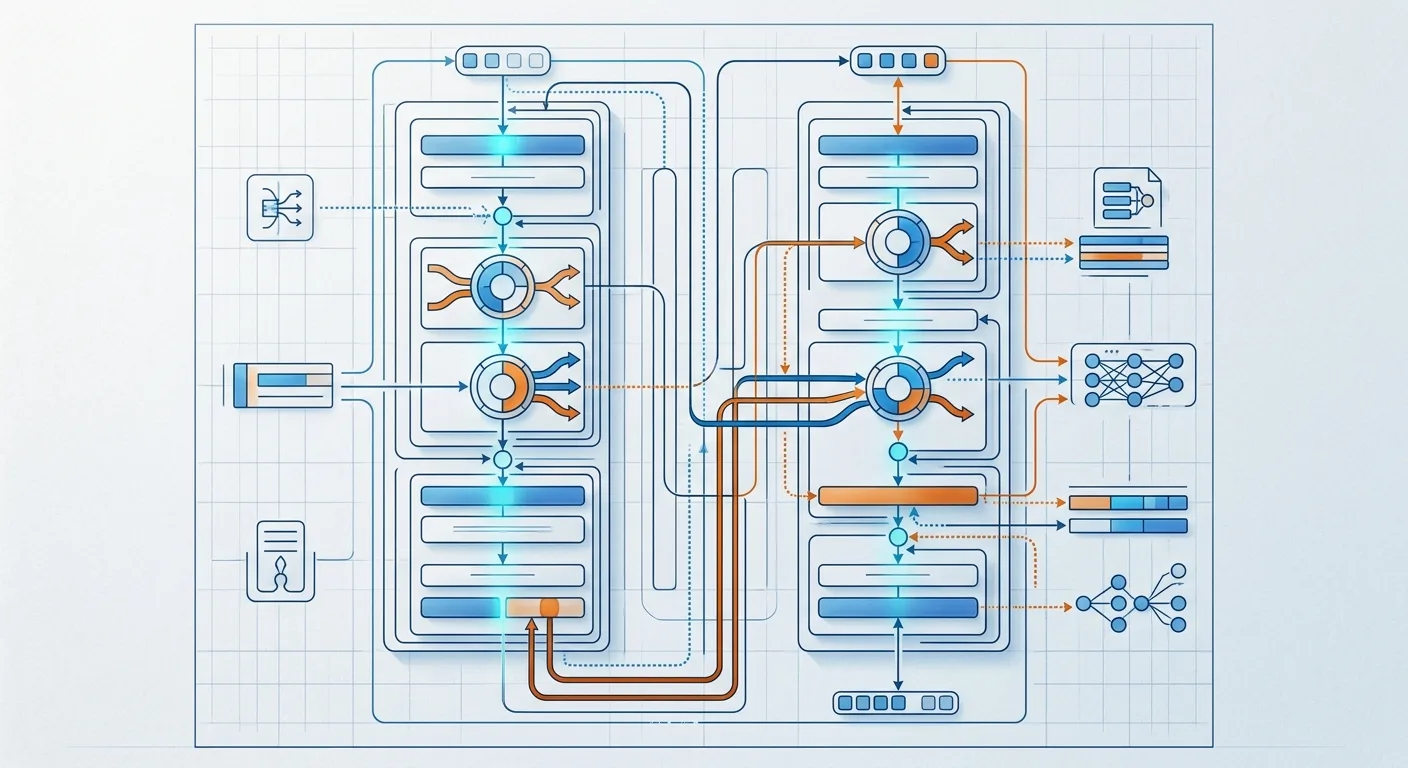
Pour nous, l'intégration du DeepSeek-V4.1-Flash avec des frameworks comme vLLM est une priorité. Les dernières mises à jour de vLLM, comme la v0.30.0, incluent un support natif pour DeepSeek-V4.1-Flash, avec des optimisations pour le stockage du KV en MXFP8 et des kernels spécifiques pour l'inférence CPU avec AVX512/AMX. Cela déverrouille des performances d'inférence exceptionnelles, même sur du matériel grand public, ce qui est essentiel pour nos clients qui ne disposent pas toujours d'infrastructures cloud massives.
Ollama joue aussi un rôle clé. Sa simplicité d'utilisation pour le déploiement de modèles en local est un atout majeur. Le DeepSeek-V4.1-Flash, une fois optimisé pour Ollama, offre une flexibilité incroyable. Nous avons déjà exploré comment Ollama, combiné à des modèles de décision, révolutionne l'agentique locale dans notre article Ollama v0.35.0 et les Modèles de Décision : Une Révolution Discrète pour l'Agentique Locale. L'arrivée du DeepSeek-V4.1-Flash dans cet écosystème ne fait qu'amplifier cette tendance, permettant des agents plus intelligents et plus autonomes directement sur nos postes de travail ou nos petits serveurs.
Des Benchmarks Agentiques Qui Parlent d'Eux-mêmes
Les benchmarks sont souvent à prendre avec des pincettes, mais ceux du DeepSeek-V4.1-Flash pour les tâches agentiques sont impressionnants. Selon les rapports de DeepSeek, à son niveau d'effort de raisonnement maximal, le modèle surpasse des géants comme GPT-5.6 Sol et Claude Opus-5.0 sur des tests comme DeepSWE v1.1 (problèmes GitHub réels), Terminal-Bench 2.1 (tâches terminales) et AutomationBench (automatisation de workflow). Le modèle obtient un score de 74.2 sur DeepSWE v1.1, 90.6 sur Terminal-Bench 2.1 et 54.8 sur AutomationBench.
C'est une performance qui valide son orientation vers les charges de travail intensives en agents. Sur des tâches complexes comme la résolution de problèmes de code ou l'orchestration de workflows, DeepSeek-V4.1-Flash montre une capacité de raisonnement et de planification qui le positionne comme un choix par défaut pour les boucles d'agents longues et gourmandes en outils. Nous avons observé des résultats similaires sur nos propres bancs d'essai, où la capacité du modèle à gérer des contextes étendus sans dégradation notable de la performance est un atout indéniable.
Bien sûr, il faut nuancer. Comme le souligne MindStudio, il y a parfois un écart entre les scores de benchmark et le rendu réel sur des tests de codage pratiques. Mais l'orientation claire vers l'agentique et les gains d'efficacité sont bien là. DeepSeek a entraîné ce modèle sur d'énormes volumes de tâches d'agents synthétiques, ce qui explique en partie ces performances spécifiques.
Impact Économique et Déploiement en Entreprise
Le nerf de la guerre en entreprise, c'est le coût. Et sur ce point, DeepSeek-V4.1-Flash est un véritable perturbateur. Kie.ai rapporte des tarifs API très compétitifs : environ 0,12 $ par million de tokens en entrée et 0,475 $ par million de tokens en sortie (tarifs hors pointe). C'est une réduction significative par rapport à d'autres modèles, ce qui permet d'envisager des applications à grande échelle sans faire exploser les budgets.
L'option de self-hosting, bien que nécessitant une mémoire GPU substantielle (environ 614 Go de VRAM pour un déploiement FP8 complet, selon Yotta Labs), offre un contrôle total sur les données et les coûts à long terme. Pour les entreprises soucieuses de la souveraineté de leurs données et de la flexibilité de leur infrastructure, c'est une piste sérieuse. Cela nous permet de construire des solutions sur mesure, adaptées aux contraintes de chaque client, sans dépendre exclusivement des API cloud.
Orchestration Agentique et Redéfinition des Workflows
L'avènement de modèles aussi performants et économiques en inférence locale a des conséquences directes sur la manière dont nous concevons les systèmes d'agents autonomes. Nous passons d'architectures où l'appel à des LLM propriétaires était un goulot d'étranglement coûteux à des systèmes où des agents locaux, propulsés par DeepSeek-V4.1-Flash, peuvent exécuter des tâches complexes avec une autonomie et une rapidité accrues. Cela ouvre la voie à une nouvelle ère d'orchestration agentique, comme nous l'avons déjà évoqué dans notre analyse Google Workspace et Gemini 3.8 Live : L'Ère de l'Orchestration Agentique Redéfinit nos Workflows.
Nous pouvons désormais envisager des architectures multi-agents plus robustes, où chaque agent, spécialisé dans une tâche (codage, analyse de texte, interaction multimodale), peut s'appuyer sur un moteur d'inférence local ultra-efficace. La capacité du DeepSeek-V4.1-Flash à gérer des inputs multimodaux nativement (texte et image) est un atout majeur pour les agents qui doivent interagir avec des environnements riches, comme l'analyse de captures d'écran ou de documents visuels.
La fonctionnalité de contrôle continu de l'effort de raisonnement (de 1 à 100) est un levier puissant pour les architectes. Elle permet de trouver le juste équilibre entre coût d'inférence et précision par requête. Pour des tâches critiques, on peut monter l'effort de raisonnement. Pour des tâches de routine, on le réduit, économisant ainsi des ressources précieuses. Cette granularité est essentielle pour optimiser les performances et les coûts de nos systèmes d'agents en production.
Défis et Perspectives pour les Prochains Mois
Malgré ses atouts, le déploiement de DeepSeek-V4.1-Flash n'est pas sans défis. L'exigence en mémoire GPU pour le self-hosting reste un investissement non négligeable pour de nombreuses structures. Nous devons continuer à explorer les optimisations logicielles (quantification, distillation) et les avancées matérielles pour rendre l'inférence locale à cette échelle encore plus accessible.
La comparaison avec d'autres modèles open source comme Qwen reste un domaine d'investigation actif. Si DeepSeek-V4.1-Flash semble plus économique sur les boucles d'agents à forte utilisation de cache, Qwen3.8 Max montre des scores de qualité composite supérieurs sur certains benchmarks. Le choix entre ces modèles dépendra toujours des spécificités du workload : latence, coût par token, précision, type de tâche (codage, vision, raisonnement). Il n'y a pas de solution universelle, et notre rôle est d'aider nos clients à naviguer dans ce paysage complexe.
Pour les mois à venir, nous anticipons une intensification de la course à l'efficacité dans l'open source. DeepSeek-V4.1-Flash a posé un jalon important. Nous surveillerons de près les prochaines versions de DeepSeek, notamment l'attendu DeepSeek-V4.1-Pro qui, bien que sans date de sortie annoncée, promet d'aller encore plus loin. C'est une période excitante pour l'IA, où l'innovation open source démocratise l'accès à des capacités auparavant réservées aux géants de la tech.
En somme, la nouvelle analyse du DeepSeek-V4.1-Flash par Kie.ai, datée d'aujourd'hui, ne fait que renforcer notre conviction : ce modèle est un game-changer. Son architecture optimisée pour l'inférence locale et les agents autonomes, combinée à une politique de prix agressive, offre des opportunités immenses pour les entreprises qui veulent intégrer l'IA de manière profonde et rentable. Chez Astoïk, nous continuons d'expérimenter, d'intégrer et de construire sur ces fondations solides pour offrir à nos clients les solutions les plus performantes et les plus adaptées à leurs besoins métiers.
Besoin d'avancer sur ce sujet ?
Discutons de vos enjeux spécifiques lors d'un audit informel.
Lou Chardin
Head of Product
Conçoit les architectures de données et les OS métiers IA d'Astoïk. Passionné par l'intégration pratique de l'IA générative.
Profil LinkedIn