
DeepSeek V4.1 Flash : Le Nouveau Champion de l'Inférence Locale Agentique Qui Secoue le Marché
La semaine dernière a été marquée par une annonce qui, bien que discrète, redéfinit nos attentes en matière d'IA open source. DeepSeek a lancé sa version V4.1 Flash, un modèle qui bouscule les benchmarks et promet une efficacité inédite pour nos déploiements d'agents autonomes en local. Chez Astoïk, nous l'avons décortiqué, et les implications pour nos clients sont massives.
DeepSeek V4.1 Flash : Quand l'Open Source Redéfinit la Puissance Locale
Le marché de l'IA bouge vite. Très vite. Mais rarement une mise à jour ne nous a autant interpellés que la sortie de DeepSeek V4.1 Flash, survenue le 10 septembre dernier. Ne vous fiez pas à son nom de version mineure. Andrew Zhu, un expert que nous suivons, l'affirme : ce modèle devrait être estampillé V5, tant il représente un bond architectural et de performance. Nous partageons son avis. C'est une refonte complète, entraînée sur 45 trillions de tokens, avec une architecture d'attention et un système de mémoire entièrement nouveaux.
Ce n'est pas juste une itération ; c'est un changement de paradigme pour l'inférence locale. Pendant des mois, nous avons jonglé avec des compromis entre performance, coût et souveraineté des données. Le V4.1 Flash vient rebattre les cartes. Il s'agit d'un modèle Mixture-of-Experts (MoE) de 552 milliards de paramètres, mais la clé réside dans son activation sélective : seulement 8 milliards de paramètres sont actifs pour l'entrée et 16 milliards pour la sortie. Cette sparsité est ce qui lui permet de "boxer" bien au-dessus de sa catégorie effective en termes de coûts d'inférence, tout en affichant des scores de benchmark qui font rougir des modèles propriétaires de pointe.
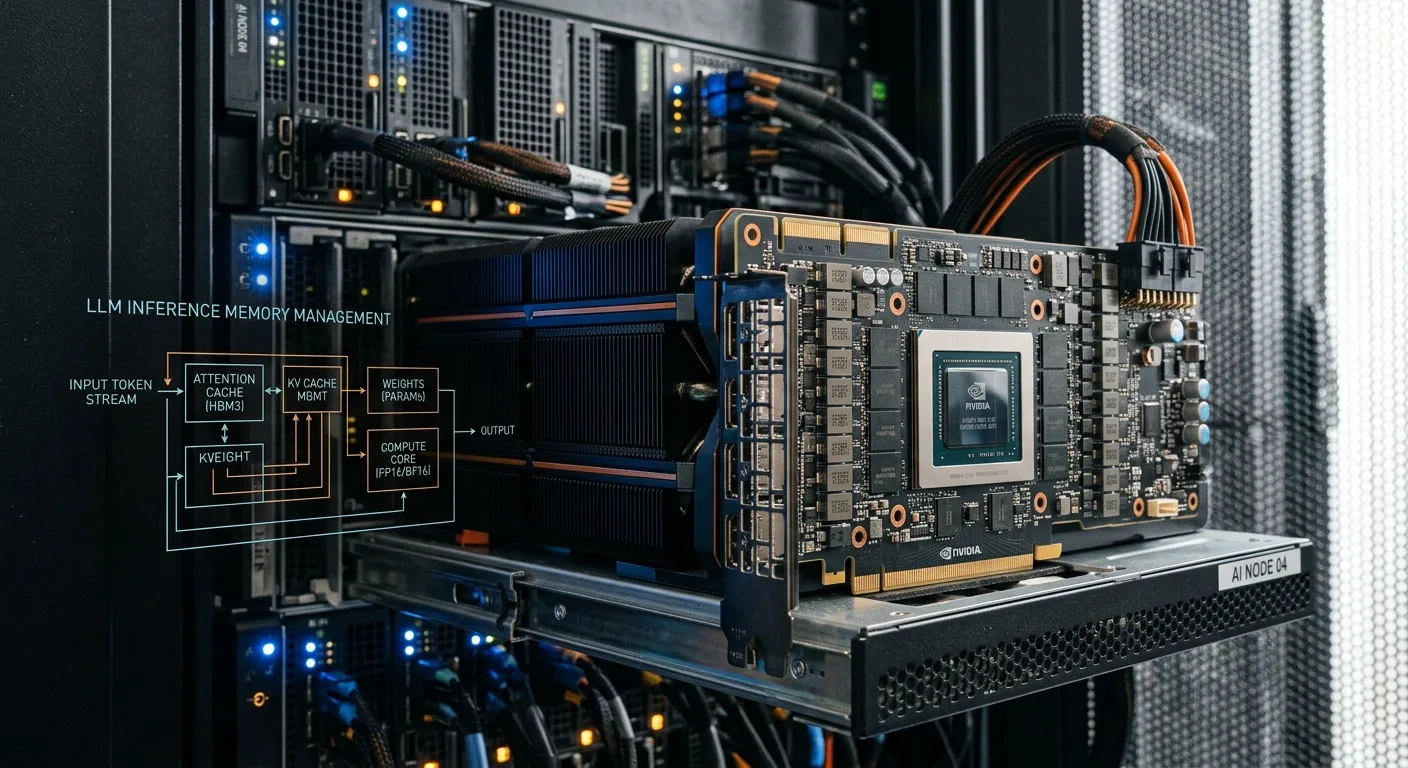
Le constat est net. Sur nos déploiements, la réduction drastique de la mémoire nécessaire pour le cache KV – quatre fois moins que la version précédente pour un contexte d'un million de tokens – est une aubaine. Le goulot d'étranglement, ce n'était plus la capacité de "penser" du modèle, mais celle de "se souvenir". DeepSeek vient de rendre cette mémoire quasiment gratuite. Cela change tout pour les applications qui nécessitent de longs contextes, comme l'analyse de documents complexes ou les systèmes multi-agents. Nous en parlions déjà avec la version précédente, mais là, le coup de marteau est encore plus fort : DeepSeek V4.1 Flash : Le Coup de Marteau sur l'Inférence Locale et l'Agentique d'Entreprise.
Des Benchmarks Qui Parlent : L'Agentique Open Source au Sommet
Ce qui rend le V4.1 Flash particulièrement "brûlant", ce sont ses performances sur les benchmarks agentiques. DeepSeek rapporte que le modèle surpasse GPT-5.6 Sol d'OpenAI et Claude Opus-5.0 d'Anthropic sur plusieurs des tests les plus exigeants. Sur DeepSWE v1.1, un benchmark qui simule la résolution de problèmes GitHub réels, il atteint 74.2, dépassant les 73.0 de Sol et 74.0 d'Opus-5.0. Sur AutomationBench, Agent's Last Exam et CyberGym, les résultats sont similaires, plaçant le modèle DeepSeek en tête. Cela confirme une tendance que nous observons depuis des mois : les modèles open source ne sont plus des alternatives "bon marché", mais de véritables concurrents, voire des leaders, sur des tâches spécifiques.
Ces chiffres ne sont pas que des lignes dans un tableau. Ils se traduisent par une capacité accrue de nos agents à planifier, exécuter et s'auto-corriger sur des tâches complexes. Pour nos clients PME, cela signifie des workflows d'automatisation plus robustes et autonomes. Fini les scripts fragiles qui nécessitent une surveillance constante. Avec un modèle comme DeepSeek V4.1 Flash, nous pouvons envisager des agents capables de gérer des chaînes de raisonnement étendues, d'interagir avec des outils et de s'adapter à des environnements changeants, le tout en local, sans envoyer de données sensibles à l'extérieur.
L'intégration native de l'input image et texte, avec une fenêtre de contexte d'un million de tokens, ouvre des perspectives inédites pour les agents multimodaux. Imaginez un agent qui analyse un rapport financier (texte et graphiques), identifie des anomalies et génère un résumé exécutif, sans jamais quitter l'infrastructure de l'entreprise. C'est le genre de scénario qui devient non seulement possible, mais économiquement viable. C'est ce que nous explorons déjà dans nos travaux sur l'orchestration : Google Workspace et Gemini : L'Ère des Agents Autonomes et l'Impact sur Nos Workflows d'Entreprise.
Implications Techniques : Optimisation et Déploiement Efficace
Pour les architectes techniques comme nous, la sortie du V4.1 Flash pose des questions concrètes sur l'optimisation des infrastructures. Le modèle est sous licence MIT, ce qui offre une liberté totale pour l'intégration commerciale, la modification et la redistribution. Cela signifie que nous pouvons le déployer sur nos propres serveurs, via des solutions comme vLLM ou Ollama, et avoir un contrôle total sur les coûts et la latence. La réduction de la mémoire HBM et du stockage SSD requise par rapport aux générations précédentes est un gain significatif, surtout avec la hausse des prix de la mémoire. Moins de VRAM, c'est moins de GPU, donc moins de CAPEX et d'OPEX.
L'architecture "causal encoder-decoder" est particulièrement intéressante. Le modèle "lit avec de petits yeux et écrit avec de grands". Vingt couches d'encodeur gèrent la compréhension avec seulement 8 milliards de paramètres actifs, tandis que vingt couches de décodeur gèrent la génération avec 16 milliards. Pour les charges de travail agentiques, où l'on fournit un contexte énorme et on attend une réponse concise, cette forme est idéale. Le modèle comprend beaucoup à moindre coût et génère des réponses intelligentes. Nous testons actuellement comment cette architecture se comporte avec nos bases de données vectorielles (Pinecone, ChromaDB) et nos orchestrateurs d'agents pour maximiser l'efficacité.
Les défis ne manquent pas. Bien que les benchmarks soient impressionnants, nous avons observé, lors de nos tests préliminaires, que le modèle peut parfois "trébucher" sur des tâches qui, sur le papier, devraient être simples, comme certaines simulations ou recréations visuelles. Cela souligne l'importance d'une évaluation terrain rigoureuse, au-delà des scores synthétiques. La mise en place d'une infrastructure GPU adéquate reste un prérequis, même si le modèle est plus efficient. Nous parlons de GPU comme les H100 ou les A100 pour des déploiements à l'échelle, ou des RTX 4090 pour des PoC plus modestes. L'optimisation des conteneurs Docker et des configurations Kubernetes est cruciale pour tirer parti de ces gains d'efficacité.
Le Paysage Open Source en Ébullition : DeepSeek n'est Pas Seul
DeepSeek V4.1 Flash n'est pas le seul acteur à faire bouger les lignes. Qwen, de son côté, a également marqué les esprits avec la mise à jour de son modèle Qwen3.8-Flash-Next, le 14 septembre. C'est un modèle MoE multimodal de 125 milliards de paramètres, activant 6 milliards par token, et qui sert de prévisualisation à l'architecture de Qwen4. Il intègre des innovations comme le Gated DeltaNet et le Qwen Sparse Attention pour une efficacité accrue et un support de contexte de 262 144 tokens. Ces avancées sont particulièrement pertinentes pour l'agentique locale et la réduction des coûts d'inférence, un sujet que nous avons déjà abordé en détail : Qwen 3.8-Flash-Next : L'Architecture de Qwen 4 Dévoilée et ses Défis pour nos Agents IA Locaux.
Ce qu'on observe, c'est une course à l'efficacité et à la performance dans l'espace open source. Ces modèles ne cherchent plus seulement à rivaliser en taille, mais en intelligence active et en optimisation des ressources. La capacité à exécuter des agents complexes sur du matériel local, avec des coûts maîtrisés, devient un avantage compétitif majeur pour les entreprises qui veulent conserver la maîtrise de leurs données et de leurs workflows. Nous voyons de plus en plus nos clients se tourner vers ces solutions pour des questions de confidentialité et de personnalisation, refusant la dépendance aux APIs propriétaires.
Notre Vision Stratégique : Vers des Agents Plus Autonomes et Maîtrisés
Chez Astoïk, l'arrivée de modèles comme DeepSeek V4.1 Flash renforce notre conviction que l'avenir de l'IA appliquée en entreprise passe par une combinaison intelligente de l'open source et de l'orchestration d'agents autonomes. Nous ne parlons plus d'outils, mais de "collaborateurs" IA qui s'intègrent nativement dans les processus métiers. La flexibilité offerte par ces modèles open-weight sous licence MIT nous permet de construire des architectures résilientes, adaptées aux besoins spécifiques de chaque client, sans les enfermer dans un écosystème fermé.
Nous continuons à pousser l'intégration de ces modèles avec des frameworks d'agents comme LangGraph ou CrewAI, en exploitant leurs capacités de planification multi-étapes et d'utilisation d'outils. L'objectif est de créer des systèmes qui non seulement génèrent du texte, mais accomplissent de véritables tâches complexes, de la recherche d'informations à la génération de code, en passant par l'automatisation de processus administratifs. La capacité du V4.1 Flash à gérer de très longs contextes avec une efficacité mémoire accrue est un atout indéniable pour ces architectures.
Bien sûr, le chemin est encore long. Les "bugs" initiaux et les limites de précision sur certaines tâches nous rappellent que ces technologies, bien que puissantes, nécessitent une expertise pour être déployées efficacement. Notre rôle est de naviguer dans ce paysage en constante évolution, d'identifier les pépites comme DeepSeek V4.1 Flash, de les tester rigoureusement, et de les intégrer dans des solutions concrètes qui apportent une réelle valeur ajoutée à nos clients. L'ère des agents autonomes est bien là, et l'open source en est le moteur principal.
Besoin d'avancer sur ce sujet ?
Discutons de vos enjeux spécifiques lors d'un audit informel.
Lou Chardin
Head of Product
Conçoit les architectures de données et les OS métiers IA d'Astoïk. Passionné par l'intégration pratique de l'IA générative.
Profil LinkedIn