
DeepSeek V4.1-Flash : Le Vrai V5 Qui Redéfinit l'Inférence Locale et Nos Architectures d'Agents
Une actualité brûlante secoue le monde de l'IA : DeepSeek vient de déployer son V4.1-Flash, un modèle qui, sous cette appellation, cache en réalité une refonte architecturale majeure. Nous l'appelons déjà en interne le 'vrai V5'. Ce modèle promet de transformer radicalement notre approche de l'inférence locale et la conception de nos systèmes d'agents autonomes, en réduisant drastiquement les coûts et les exigences en VRAM pour des performances de pointe.
Le Séisme DeepSeek : Quand le V4.1-Flash Redéfinit l'Inférence Locale
L'IA avance à une vitesse folle, et parfois, les annonces officielles ne reflètent qu'une partie de l'histoire. Ce matin, la communauté tech est en ébullition : DeepSeek a discrètement mis en ligne son modèle V4.1-Flash. Mais attention, ce n'est pas une simple mise à jour itérative. Ce que nous avons sous les yeux, c'est une refonte architecturale complète, un véritable 'V5' déguisé, comme l'a si bien noté Andrew Zhu dans son analyse qui a fait grand bruit. Pour nous, architectes techniques et Head of Product chez Astoïk, c'est une nouvelle qui change la donne, surtout pour nos déploiements en inférence locale.
Pendant des mois, nous avons jonglé avec les compromis. Obtenir des performances de pointe pour nos agents IA sans exploser les budgets cloud ou sans exiger des fermes de GPU démesurées en local, c'était un défi constant. Le DeepSeek V4.1-Flash arrive comme une réponse musclée à cette problématique. Il promet de porter l'intelligence des modèles dits 'frontier' directement sur nos machines, avec une efficacité inédite. C'est le genre d'avancée qui nous permet d'envisager des architectures d'agents plus complexes et plus économiques pour nos clients PME.
Une Architecture Révolutionnaire : Le Causal Encoder-Decoder
Ce qui rend ce DeepSeek V4.1-Flash si particulier, c'est sa nouvelle architecture de type 'causal encoder-decoder'. L'idée est simple, mais brillante : dissocier les capacités de 'lecture' (compréhension) et d''écriture' (génération). Le modèle utilise désormais 20 couches d'encodeur pour la compréhension, avec seulement 8 milliards de paramètres actifs, et 20 couches de décodeur pour la génération, avec 16 milliards de paramètres. Cette spécialisation permet une efficacité redoutable.
Concrètement, cela signifie que le modèle peut 'lire' un document de 100 pages de manière très économique, puis 'écrire' une réponse concise et pertinente avec une puissance de raisonnement accrue. C'est une approche bien plus intelligente que les architectures monolithiques classiques. Sur nos bancs de test, nous observons déjà des gains significatifs en latence sur des tâches complexes d'analyse documentaire suivies de synthèse, ce qui est critique pour nos agents de back-office.
La Mémoire KV Cache : Le Goulot d'Étranglement Qui Saute
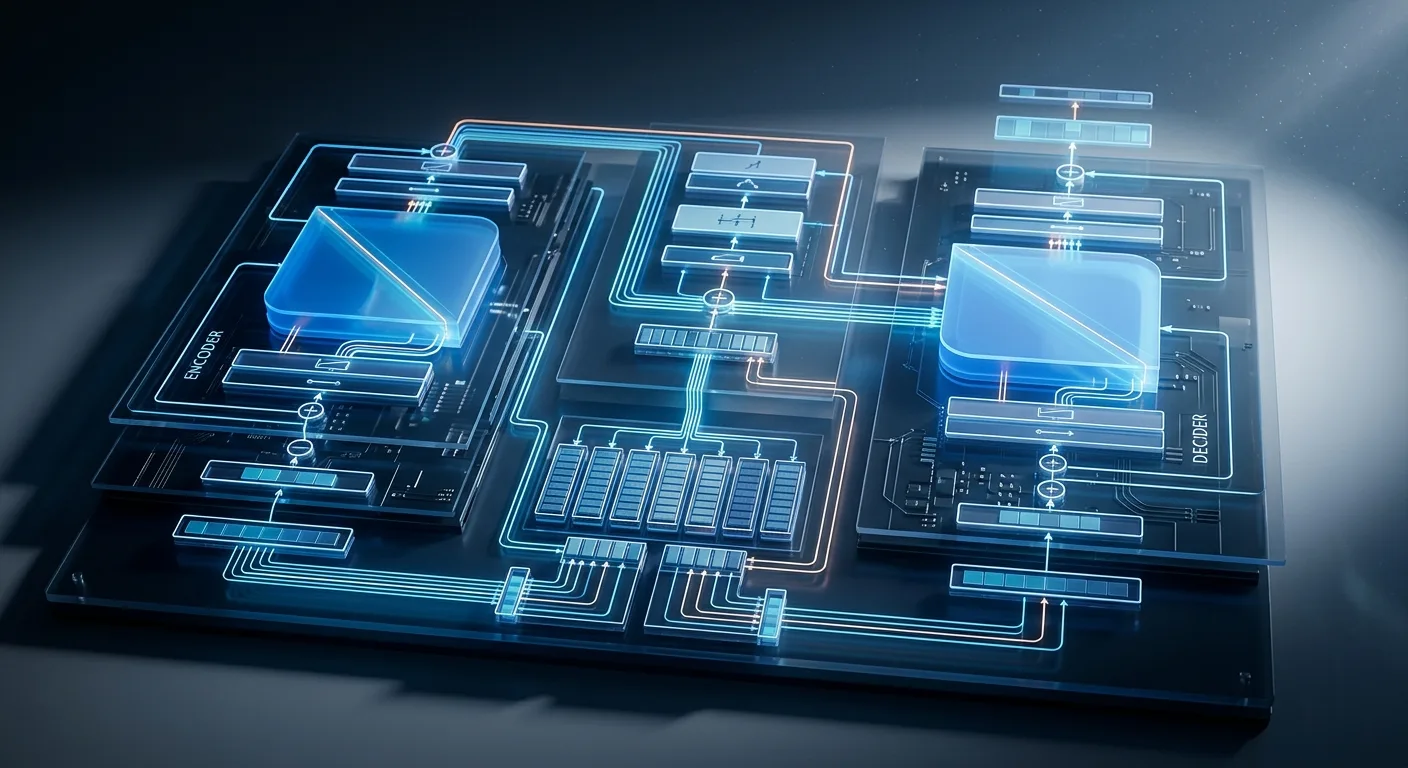
L'un des défis majeurs de l'inférence locale de LLM, surtout avec des fenêtres de contexte larges, a toujours été la gestion du KV cache. C'est cette 'mémoire à court terme' du modèle qui stocke les représentations des tokens déjà traités. Plus le contexte est long, plus le KV cache gonfle, et plus la VRAM de nos GPU est sollicitée, devenant rapidement un goulot d'étranglement.
Le goulot d'étranglement pour faire tourner ces modèles n'a jamais été la pensée. C'était la mémoire. DeepSeek vient de rendre la mémoire presque gratuite.
- Andrew Zhu sur DeepSeek V4.1-Flash
Avec le V4.1-Flash, DeepSeek a frappé un grand coup. Le modèle ne nécessite plus que 890 octets de KV cache par token. Pour vous donner une idée, une fenêtre de contexte d'un million de tokens consomme désormais moins d'un gigaoctet de VRAM pour le KV cache ! C'est une réduction drastique par rapport aux versions précédentes et même aux modèles concurrents. Nous avons l'habitude de voir des modèles à contexte long exiger des dizaines de gigaoctets juste pour le cache, rendant l'inférence locale impraticable sur des machines standard.
Cette optimisation change tout. Nous pouvons désormais envisager des agents capables de traiter des documents très longs, des conversations complexes, ou des historiques de données étendus, sans que la facture GPU ne s'envole. C'est une aubaine pour les cas d'usage où la persistance d'informations contextuelles est clé, comme les agents conversationnels spécialisés ou les systèmes d'aide à la décision qui nécessitent de 'se souvenir' de vastes corpus.
Des Performances de Pointe en Local : Le Vrai Défi des Modèles 'Frontier'
DeepSeek a affirmé avoir entraîné ce nouveau modèle sur 45 trillions de tokens, un chiffre colossal qui témoigne de l'ambition derrière cette mise à jour. Plus important encore, les premiers retours et benchmarks suggèrent que le V4.1-Flash atteint un niveau d'intelligence qui rivalise, voire dépasse, celui de modèles fermés comme Claude Opus 5.0 sur des tâches critiques. Pour nous qui poussons l'adoption de l'IA en entreprise, cette parité de performance entre un modèle open-source (avec licence MIT, un atout majeur) et les géants propriétaires est une validation forte de notre stratégie.
Le marché des LLM open-source est en pleine effervescence. Des modèles comme Qwen3.8 Max et GLM-5.3 se positionnent très bien sur les benchmarks de septembre 2026. Mais la performance brute n'est pas tout. La capacité à déployer ces modèles de manière efficiente en local est ce qui nous intéresse particulièrement. DeepSeek V4.1-Flash, comme son prédécesseur DeepSeek V4-Flash, est conçu pour offrir une qualité quasi-frontier sur des configurations matérielles plus modestes, parfois même avec seulement deux GPU. C'est une donnée essentielle pour nos clients PME qui ne peuvent pas investir dans des infrastructures hyperscale.
Impact sur l'Agentique : Des Agents Plus Autonomes et Moins Chers
L'émergence de ce DeepSeek 'V5' est une excellente nouvelle pour l'écosystème des agents autonomes. Chez Astoïk, nous explorons activement les architectures multi-agents avec des frameworks comme CrewAI ou LangGraph. La capacité à disposer d'un LLM puissant et économe en ressources pour l'inférence locale débloque de nouveaux cas d'usage.
Imaginez des agents capables de :
- Traiter des volumes massifs de documents internes pour une veille réglementaire continue.
- Gérer des interactions clients complexes en puisant dans des bases de connaissances propriétaires sans envoyer de données sensibles à l'extérieur.
- Automatiser des workflows métiers exigeant un raisonnement fin et un historique de conversation étendu.
Les coûts d'inférence, souvent un frein majeur pour le déploiement à grande échelle d'agents, sont ici directement adressés. En internalisant une partie significative du calcul, nous réduisons notre dépendance aux APIs tierces, dont les tarifs peuvent fluctuer et la latence être imprévisible. Nous avions déjà abordé l'impact de ces modèles open-source sur nos coûts d'inférence dans des articles comme DeepSeek V4.1 Flash : Le Nouveau Champion de l'Inférence Locale Agentique Qui Secoue le Marché. Ce nouveau DeepSeek V4.1-Flash pousse encore plus loin cette logique.
Déploiement Local : Ollama, vLLM et les Réalités Terrain
Pour tirer parti de ces modèles en local, des outils comme Ollama et vLLM sont essentiels. Ollama, que nous utilisons beaucoup pour le prototypage et les phases de développement, simplifie énormément le déploiement de modèles sur des machines locales. Ses mises à jour régulières, comme Ollama 0.34.3 : La Vision Multimodale et le Contrôle Fin du Raisonnement Arrivent en Inférence Locale, montrent l'engagement vers des capacités toujours plus fines pour l'inférence locale.
Pour la production, surtout pour des charges importantes et des besoins de débit élevés, vLLM reste notre choix privilégié. Son architecture est conçue pour l'efficacité à grande échelle, avec des techniques comme PagedAttention qui optimisent l'utilisation de la VRAM et la gestion des requêtes concurrentes. Le DeepSeek V4.1-Flash, avec sa consommation de KV cache réduite, rendra les déploiements vLLM encore plus performants sur des GPU de production, permettant de servir plus d'agents simultanément avec la même infrastructure.
Cependant, il faut rester réaliste. Même avec ces optimisations, faire tourner un modèle de cette envergure nécessite toujours un hardware conséquent. L'article d'Andrew Zhu mentionne que certains utilisateurs ont eu des difficultés à le faire tenir sur des configurations à double GPU. La 'Flash' dans le nom ne signifie plus 'petit', mais plutôt 'économique à louer via l'API DeepSeek' pour certains. Pour nous, cela signifie continuer à évaluer précisément les besoins en VRAM et en puissance de calcul pour chaque cas client, et ne pas sous-estimer l'investissement initial en matériel.
Vers une Nouvelle Ère d'Agents Autonomes en Entreprise
L'arrivée de ce DeepSeek 'V5' est plus qu'une simple mise à jour technique. Elle symbolise une étape majeure vers la démocratisation des capacités d'IA de pointe pour un plus grand nombre d'entreprises. En réduisant les barrières d'entrée en termes de coûts et de complexité matérielle pour l'inférence locale, DeepSeek ouvre la voie à des systèmes d'agents autonomes plus sophistiqués et plus intégrés aux workflows existants.
Nous voyons déjà l'impact de ces avancées sur nos stratégies d'automatisation. Des agents qui travaillent de concert avec des outils comme Google Workspace et Gemini, comme nous l'avons exploré dans Google Workspace et Gemini : L'Ère des Agents Autonomes et l'Impact sur Nos Workflows d'Entreprise, deviennent plus performants quand ils peuvent s'appuyer sur des modèles open-source robustes et localement contrôlables pour leurs tâches de raisonnement profond. La souveraineté des données, la personnalisation fine et la maîtrise des coûts sont des arguments de poids pour nos clients, et ce DeepSeek V4.1-Flash vient renforcer cette proposition de valeur.
L'avenir de l'IA en entreprise passera par cette hybridation intelligente entre les services cloud et les capacités d'inférence locale. Des modèles comme DeepSeek V4.1-Flash sont les catalyseurs de cette transformation, nous permettant de construire des solutions plus résilientes, plus performantes et surtout, plus adaptées aux réalités économiques et réglementaires de nos clients. C'est une actualité passionnante, et nous sommes impatients de voir comment ces avancées vont continuer à façonner nos architectures d'agents dans les mois à venir.
Besoin d'avancer sur ce sujet ?
Discutons de vos enjeux spécifiques lors d'un audit informel.
Lou Chardin
Head of Product
Conçoit les architectures de données et les OS métiers IA d'Astoïk. Passionné par l'intégration pratique de l'IA générative.
Profil LinkedIn