
DeepSeek V4.1-Flash et vLLM : Quand l'Inférence Locale Redéfinit l'Agentique d'Entreprise, loin des promesses de V5
Alors que les rumeurs autour de DeepSeek V5 persistent, la véritable actualité brûlante se trouve dans les performances de DeepSeek-V4.1-Flash. Ce modèle, combiné aux optimisations récentes de vLLM, transforme radicalement l'inférence locale pour les systèmes d'agents autonomes, offrant une efficacité et une maîtrise des coûts inédites pour les entreprises.
DeepSeek V5 : L'Arlésienne continue, mais V4.1-Flash est bien réelle et performante
Chez Astoïk, nous suivons de près les annonces autour des modèles de langage, et force est de constater que DeepSeek V5 est devenu une véritable Arlésienne. Depuis des semaines, les spéculations vont bon train sur une sortie imminente, avec des rumeurs d'une architecture complètement nouvelle et de performances dignes de "GPT-6 Astra". Pourtant, au 7 octobre 2026, aucune annonce officielle n'est venue confirmer ces bruits de couloir. Le site de DeepSeek et son changelog API restent muets sur un V5, et toutes les allégations spécifiques à une sortie en septembre sont basées sur des fuites non vérifiées.
Pendant que certains attendent, nous nous concentrons sur ce qui est concret : DeepSeek-V4.1-Flash. Ce modèle, officiellement lancé le 10 septembre 2026, est présenté comme le plus petit de leur nouvelle famille architecturale et intègre déjà une compréhension visuelle multimodale native. C'est une pièce maîtresse pour l'inférence locale et l'agentique d'entreprise, et c'est là que se jouent les véritables avancées pour nos clients.
V4.1-Flash et vLLM : Une synergie qui booste l'agentique locale
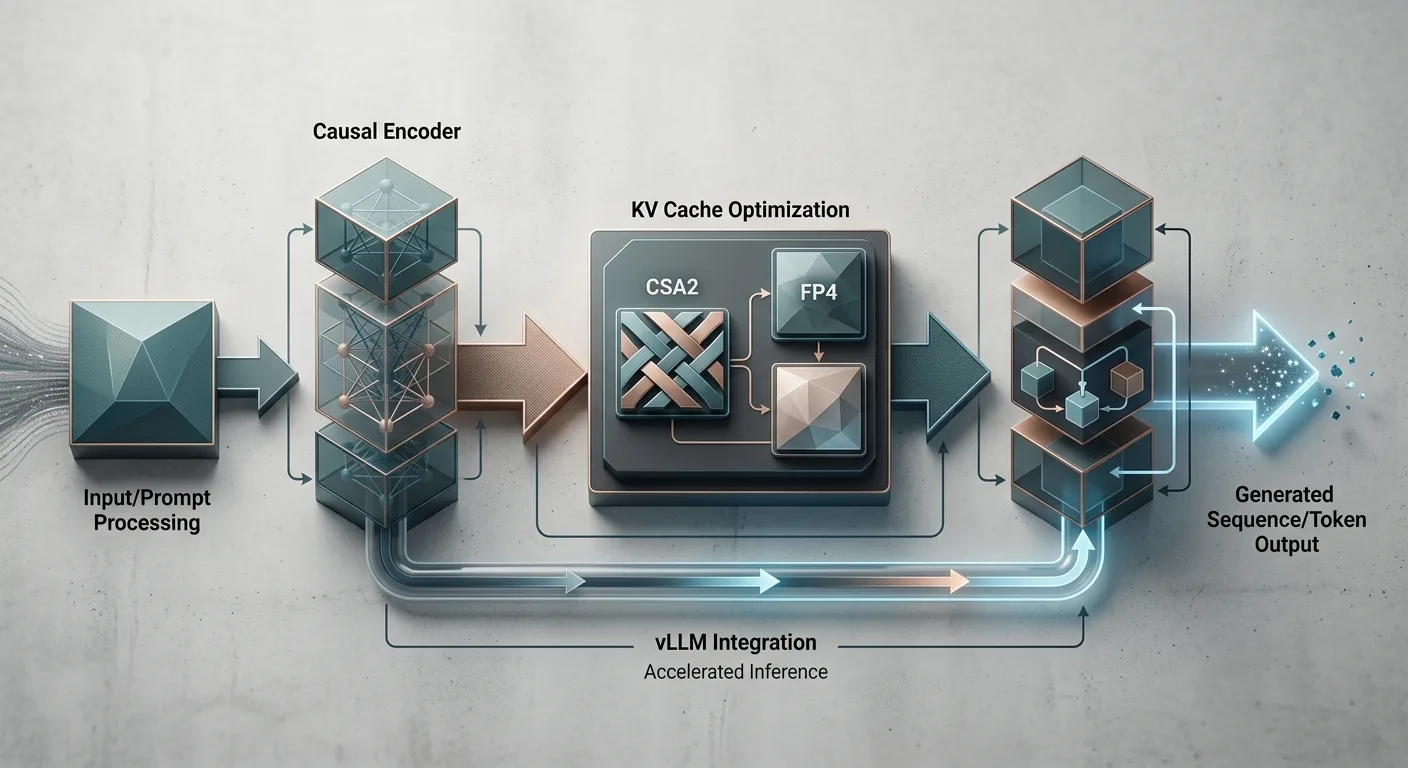
La nouvelle qui nous a le plus marqué ces dernières 24-48 heures, c'est l'optimisation spectaculaire de DeepSeek-V4.1-Flash sur vLLM. Le 7 octobre 2026, Inferact et la communauté vLLM ont publié des travaux montrant une amélioration de débit de 5,3 fois pour les tâches de service agentiques, sous une contrainte de 150 TPS. C'est colossal. Sur nos déploiements, la latence est souvent le nerf de la guerre. Réduire le temps de première réponse (TTFT) de près de 30% grâce au SWA bounded replay et aux CUDA graphs, c'est un gain direct pour les workflows d'agents autonomes.
Cette performance est le fruit d'une architecture ingénieuse. DeepSeek V4.1-Flash utilise une architecture encodeur-décodeur causale (CED) qui active 16 milliards de paramètres par jeton en phase de décodage, mais seulement 8 milliards en phase de préremplissage. Le modèle est également extrêmement économe en mémoire, avec une empreinte KV cache globale réduite à 890 octets par jeton grâce à des techniques comme le Compressed Sparse Attention 2 (CSA2) et le KV cache FP4. Ce n'est pas juste une amélioration incrémentale, c'est une refonte fondamentale qui permet de faire tourner des agents complexes sur des infrastructures plus modestes, directement sur nos serveurs.
L'Impact sur l'Agentique d'Entreprise : Coût, Contrôle et Sécurité
Pour les entreprises qui cherchent à déployer des systèmes d'agents, l'équation est simple : minimiser les coûts tout en maximisant la performance et le contrôle. Les modèles comme DeepSeek-V4.1-Flash, couplés à des solutions d'inférence locale performantes comme Ollama ou vLLM, changent la donne. Nous avons déjà abordé dans nos articles l'importance stratégique de l'inférence locale pour nos agents décisionnels (Ollama v0.35.1 : Quand l'Inférence Locale Devient Stratégique pour nos Agents Décisionnels). Avec V4.1-Flash, nous atteignons un nouveau seuil.
Le coût est un facteur décisif. Les modèles DeepSeek sont notoirement moins chers que leurs homologues occidentaux. V4-Flash est environ 7,7 fois moins cher que Qwen3.6-Plus sur une charge de travail typique de chatbot. Cette différence, nous la voyons directement sur les factures de nos clients. Quand une tâche agentique nécessite des dizaines, voire des centaines d'appels au modèle pour itérer et corriger, chaque centime compte. Uber a épuisé son budget annuel de jetons en quatre mois, et Salesforce fait face à des coûts Anthropic de 300 millions de dollars cette année. C'est une réalité brutale. L'adoption de DeepSeek par les entreprises américaines est en hausse, motivée par la pression financière.
Le contrôle des données est un autre point crucial. En inférant localement, les entreprises gardent la main sur leurs informations sensibles, un avantage non négligeable face aux préoccupations réglementaires (notamment l'EU AI Act) et aux risques de fuites. Cependant, l'utilisation des APIs DeepSeek soulève des questions de conformité et de sécurité pour les entreprises occidentales, car les données peuvent être stockées sur des serveurs en Chine. C'est un point que nous clarifions systématiquement avec nos clients : l'inférence locale avec les poids ouverts est la voie royale pour la souveraineté des données.
DeepSeek-V4.1-Flash face à la concurrence : Un champion de l'efficience
Nous avons déjà beaucoup parlé de DeepSeek-V4.1-Flash comme un potentiel nouveau champion pour l'agentique d'entreprise (DeepSeek-V4.1-Flash : Le Nouveau Champion de l'Inférence Locale et de l'Agentique d'Entreprise ?). Les benchmarks récents confirment cette tendance. DeepSeek V4 Flash excelle sur les tâches de connaissance et de codage pur, avec des scores élevés sur MMLU-Pro (86.2), LiveCodeBench (91.6) et SWE-bench Verified (79.0). C'est une force brute pour la génération de code et le raisonnement, des capacités fondamentales pour des agents autonomes efficaces.
Comparé à Qwen, DeepSeek V4-Flash montre une nette avance en termes de coût et de performance pour le codage agentique. Un test a montré que V4-Flash atteint 73.7 sur SWE-bench Verified, le score le plus élevé parmi les modèles ouverts comparés, tandis que Qwen 480B Coder est à 69.6. La vitesse est également un atout : DeepSeek offre des temps de réponse inférieurs à une seconde pour le premier jeton avec 10 000 jetons en entrée, ce qui rend les boucles agentiques beaucoup plus fluides. Pour les architectures multi-agents où chaque interaction compte, cette rapidité est un game changer.
Limites actuelles et perspectives Astoïk
Malgré ses atouts, DeepSeek-V4.1-Flash n'est pas une solution universelle. Nous avons observé des lacunes sur certaines tâches complexes, où il reste en retrait par rapport aux modèles américains de pointe en matière de cybersécurité, de raisonnement abstrait et de tâches logicielles non publiques. La résistance aux jailbreaks et au détournement est également plus faible, ce qui impose des garde-fous plus robustes lors de la conception d'agents ou de chatbots. La censure et les biais narratifs, notamment sur des sujets politiquement sensibles, sont aussi des points d'attention à gérer, surtout pour les applications grand public ou de recherche.
L'absence d'un plan d'entreprise publié pour l'API DeepSeek, avec des tarifs et des conditions de service au niveau entreprise, est une autre limitation. Pour nos intégrations, cela signifie que nous devons souvent bâtir des couches d'abstraction supplémentaires pour garantir la stabilité et la prédictibilité des coûts, ou privilégier le déploiement local des poids ouverts.
Chez Astoïk, notre stratégie reste pragmatique. Nous exploitons les modèles open source comme DeepSeek-V4.1-Flash pour leur efficience et leur flexibilité, en les combinant avec des outils d'orchestration d'agents et des bases de données adaptées (PostgreSQL pour la persistance, Redis pour le cache des états, Pinecone pour la RAG avancée). L'objectif est de construire des architectures robustes et maîtrisées, en intégrant les dernières avancées comme celles de vLLM, tout en restant conscients des limites. L'arrivée hypothétique de DeepSeek V5 sera scrutée avec attention, mais en attendant, V4.1-Flash est déjà en production et génère de la valeur pour nos clients.
Le marché des modèles de langage est en constante évolution, avec une cadence de sortie rapide. Entre avril et septembre 2026, DeepSeek a eu cinq sorties ou retraits de modèles sur son API. Cela signifie qu'une gestion rigoureuse des versions et des tests de régression sont indispensables pour maintenir la stabilité de nos applications.
Pour nos clients, l'essentiel est de choisir le bon modèle pour la bonne tâche, en évaluant non seulement les performances brutes, mais aussi les coûts d'inférence, les exigences en VRAM, la latence et les implications en termes de souveraineté des données. DeepSeek-V4.1-Flash, avec ses optimisations récentes sur vLLM, est clairement un acteur majeur dans cette équation, surtout pour les applications agentiques gourmandes en calcul local.
Nous continuerons à surveiller les développements de DeepSeek et d'autres acteurs open source. L'innovation est rapide, et notre rôle est de la transformer en solutions concrètes et efficaces pour vos défis métiers.
Besoin d'avancer sur ce sujet ?
Discutons de vos enjeux spécifiques lors d'un audit informel.
Lou Chardin
Head of Product
Conçoit les architectures de données et les OS métiers IA d'Astoïk. Passionné par l'intégration pratique de l'IA générative.
Profil LinkedIn