
DeepSeek V4.1-Flash et vLLM : Le Débit Agentique S'Envole, Nos Retours sur une Révolution en 48h
En tant qu'architecte technique chez Astoïk, je suis les évolutions de près. Les dernières 48 heures ont été riches : les optimisations de vLLM pour DeepSeek V4.1-Flash ont fait exploser le débit agentique, redéfinissant les standards de l'inférence locale. C'est une avancée majeure pour nos déploiements en entreprise.
Chez Astoïk, nous le disons souvent : l'IA est un marathon, pas un sprint. Mais parfois, une étincelle transforme la course en explosion. C'est exactement ce qui s'est passé ces dernières 48 heures avec DeepSeek V4.1-Flash et vLLM. Nous avons vu le débit agentique s'envoler, confirmant une tendance que nous anticipions sur l'inférence locale.
Le constat est net. Ce n'est pas une simple mise à jour incrémentale. Ce sont des optimisations profondes qui changent la donne pour nos clients et nos architectures. Cela impacte directement la capacité à déployer des agents autonomes performants, sans dépendre systématiquement des APIs cloud coûteuses et parfois limitantes.
L'Accélération Foudroyante de DeepSeek V4.1-Flash sur vLLM
La nouvelle est tombée le 7 octobre : vLLM, en collaboration avec Inferact, a publié des optimisations massives pour DeepSeek V4.1-Flash. Le résultat est spectaculaire. Ils ont annoncé une accélération de 1,9 fois à faible concurrence et une amélioration du débit de 5,3 fois sous une contrainte de 150 transactions par seconde (TPS) sur des charges de travail agentiques.
C'est un chiffre qui parle. Pour nous, architectes techniques, cela signifie que nos infrastructures actuelles peuvent gérer bien plus. Moins de GPUs, plus de requêtes, des coûts maîtrisés. C'est l'équation gagnante que nous cherchons constamment.
Les Secrets Techniques Derrière le Bond de Performance
Ces gains ne sortent pas de nulle part. Ils sont le fruit d'un travail d'ingénierie poussé. Trois axes majeurs ont été exploités:
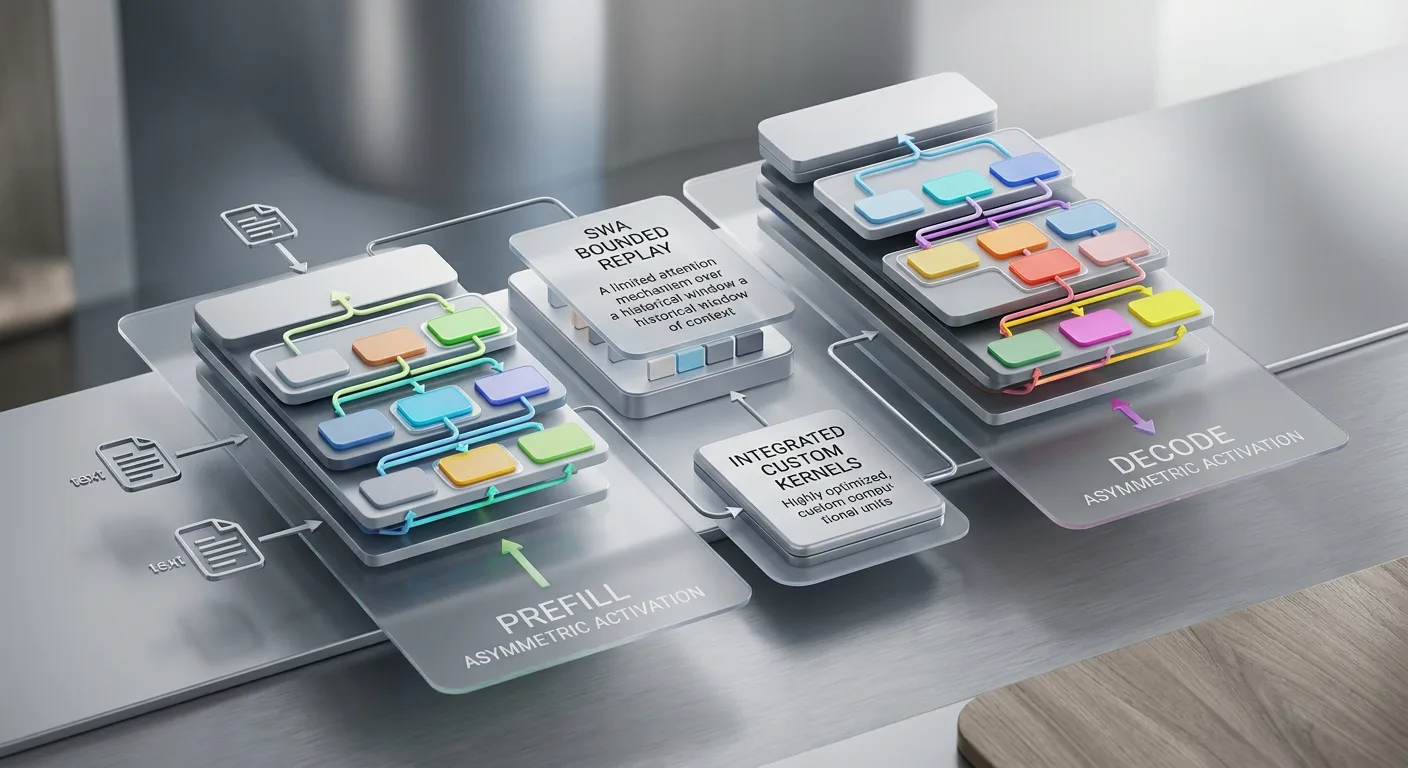
- Le SWA bounded replay avec CUDA graphs : Cette technique a permis une réduction d'environ 30% du Time To First Token (TTFT), un indicateur critique pour la réactivité des agents.
- L'intégration des nouveaux kernels DeepSeek : Des optimisations au niveau des opérateurs fondamentaux du modèle, comme MegaAttention, Mega-mHC, Mega-Gate et DeepSelect, ont été directement intégrées, exploitant au mieux l'architecture du modèle.
- La fusion et la parallélisation agressives des kernels vLLM : Des opérations qui étaient auparavant séquentielles sont maintenant exécutées en parallèle ou fusionnées, réduisant drastiquement les surcharges et maximisant l'utilisation des unités de calcul du GPU.
Ce sont des détails qui comptent. Quand on parle de latence et de débit à l'échelle, chaque milliseconde, chaque instruction optimisée fait une différence monumentale. Nous avons d'ailleurs beaucoup écrit sur l'importance du débit agentique et de l'inférence locale. Pour ceux qui veulent approfondir, notre article DeepSeek-V4.1-Flash et vLLM : Le 5x de Débit Agentique Qui Bouleverse l'Inférence Locale détaille déjà une partie de ces avancées, et le dernier développement ne fait que confirmer cette trajectoire.
DeepSeek V4.1-Flash : Une Architecture Conçue pour l'Efficacité Agentique
Il faut aussi souligner que DeepSeek V4.1-Flash n'est pas un modèle comme les autres. Son architecture de type 'causal encoder-decoder' (CED) est particulièrement bien pensée pour les tâches agentiques à long terme. Le modèle active 16 milliards de paramètres par token pendant la phase de décodage, mais seulement 8 milliards pendant le préfill.
Cette asymétrie est clé. Le préfill, qui est souvent le goulot d'étranglement pour les contextes longs, est allégé. De plus, le modèle est extrêmement efficace en mémoire, grâce à des techniques comme le Compressed Sparse Attention 2 (CSA2), le cache KV en FP4 et le partage du cache KV inter-couches. Cela réduit l'empreinte globale du cache KV à seulement 890 octets par token.
Moins de VRAM consommée, c'est plus de requêtes par GPU, ou la possibilité de faire tourner des modèles plus grands sur du hardware plus modeste. C'est une réalité terrain qui nous permet de proposer des solutions plus accessibles et plus scalables à nos clients.
DeepSeek V4.1-Flash : Le Leader sur les Benchmarks d'Agentic Coding
Ces performances techniques se traduisent directement sur les benchmarks. Le 6 octobre, des analyses ont montré que DeepSeek V4.1-Flash a dépassé le modèle leader d'Anthropic sur les benchmarks d'agentic coding. Un score de 77.3 pour DeepSeek contre 66.1 pour Anthropic sur un snapshot LiveBench du 4 octobre.
L'agentic coding n'est pas un benchmark anecdotique. Il mesure la capacité d'un modèle à planifier une tâche logicielle complexe, écrire le code, l'exécuter, lire les erreurs et les corriger de manière autonome. C'est le Graal pour l'automatisation logicielle en entreprise. Que DeepSeek V4.1-Flash prenne la tête sur ce point est un signal fort pour le marché.
Cela confirme notre positionnement chez Astoïk : les modèles open-source, lorsqu'ils sont bien optimisés et intégrés, peuvent rivaliser, voire surpasser, les offres propriétaires sur des cas d'usage précis et à forte valeur ajoutée. Notre article DeepSeek-V4.1-Flash : Le Nouveau Champion de l'Inférence Locale et de l'Agentique d'Entreprise ? abordait déjà cette question de leadership, et les faits nous donnent raison.
Implications pour l'Entreprise : Vers une Inférence Locale Toujours Plus Puissante
Pour nos déploiements chez les clients, ces avancées sont cruciales. L'amélioration du débit et l'efficacité mémoire de DeepSeek V4.1-Flash sur vLLM signifient que nous pouvons désormais envisager des architectures d'agents autonomes encore plus ambitieuses, avec des coûts d'infrastructure réduits. Pensez à des agents capables de traiter des volumes de données transactionnelles massifs, ou d'orchestrer des workflows complexes en temps réel, le tout sur des serveurs privés. C'est une promesse de souveraineté et de performance qui se concrétise.
La compatibilité de vLLM avec de nouvelles plateformes matérielles est également un point essentiel. Le 9 octobre, vLLM a annoncé son support pour NVIDIA Vera Rubin NVL72, offrant un débit 7,8 fois supérieur à celui du GB200 NVL72. C'est une nouvelle qui nous intéresse particulièrement pour les déploiements à très grande échelle, où chaque watt et chaque gigaoctet de VRAM sont optimisés au maximum. Ces machines sont des bêtes de course, et les voir exploitées à ce niveau de performance par vLLM pour des modèles comme DeepSeek V4.1-Flash ouvre des horizons incroyables pour nos clients grands comptes.
Les Défis Restants et Notre Vision
Malgré ces avancées, des défis subsistent. L'intégration de ces technologies reste complexe et nécessite une expertise pointue. Il ne suffit pas de télécharger un modèle et un runtime pour obtenir des performances optimales. La configuration des kernels, l'optimisation du cache KV, la gestion de la parallélisation – tout cela demande une connaissance approfondie de l'architecture matérielle et logicielle. C'est là qu'Astoïk intervient, en transformant ces innovations en solutions concrètes et fiables pour les entreprises.
Nous continuons de suivre de près la feuille de route de vLLM pour le quatrième trimestre 2026, qui promet de nouvelles optimisations pour DeepSeek V4.1, GLM 5.3 et Qwen3.8, ainsi que des améliorations pour le support AMD et le déploiement des services agentiques. La course à l'efficacité est loin d'être terminée, et nous sommes au premier rang pour observer et intégrer ces changements.
L'écosystème de l'inférence locale est en pleine effervescence. Des outils comme Ollama continuent également d'évoluer. La version v0.40.3 d'Ollama, sortie le 11 octobre, bien que moins axée sur les gains de débit massifs, montre un travail continu sur l'expérience utilisateur et l'intégration de modèles de décision. La disponibilité de Gemma 4 sur Ollama, avec ses capacités multimodales et son optimisation pour les appareils edge, est aussi un signe que l'inférence locale se diversifie et s'adapte à de nouveaux usages.
Notre mission chez Astoïk est de décrypter ces tendances, de tester ces technologies en conditions réelles et de les rendre opérationnelles pour nos clients. Le bond en avant de DeepSeek V4.1-Flash sur vLLM est un exemple parfait de la rapidité avec laquelle le paysage de l'IA évolue. C'est stimulant, et ça nous pousse à être constamment à la pointe.
Besoin d'avancer sur ce sujet ?
Discutons de vos enjeux spécifiques lors d'un audit informel.
Lou Chardin
Head of Product
Conçoit les architectures de données et les OS métiers IA d'Astoïk. Passionné par l'intégration pratique de l'IA générative.
Profil LinkedIn