
DeepSeek-V4.1-Flash sur vLLM : Quand 5x de Débit Agentique Redéfinit l'Inférence Locale en 48h
Une actualité brûlante vient de secouer le monde de l'IA locale : des optimisations récentes de DeepSeek-V4.1-Flash sur vLLM ont multiplié par cinq son débit pour les tâches agentiques. C'est une avancée majeure qui, couplée à la dernière mise à jour d'Ollama, redessine les contours de l'agentique d'entreprise sur nos infrastructures. Nous sommes à l'aube d'une nouvelle ère pour la souveraineté numérique des PME.
Chez Astoïk, nous sommes constamment à l'affût des innovations qui peuvent concrètement améliorer nos déploiements d'IA. Et ces dernières 48 heures ont été particulièrement révélatrices. Une série d'optimisations techniques sur DeepSeek-V4.1-Flash, notamment via vLLM, a provoqué une véritable onde de choc dans le milieu de l'inférence locale. Nous parlons d'un gain de performance tel qu'il force à reconsidérer ce que nous pensions réalisable avec des modèles open source sur du hardware standard. C'est le genre de nouvelle qui change une roadmap technique, et qui, pour nos clients PME, signifie une autonomie et une efficacité inédites.
DeepSeek-V4.1-Flash et vLLM : 5x de Débit, Une Révolution Agentique
Le constat est net. Depuis sa sortie début septembre, DeepSeek-V4.1-Flash s'était déjà imposé comme un modèle de référence pour l'inférence locale grâce à son architecture MoE (Mixture-of-Experts) efficiente et sa capacité à gérer des contextes d'un million de tokens. Mais les équipes d'Inferact et la communauté vLLM ne se sont pas arrêtées là. Des travaux d'optimisation intensifs, dont les résultats ont été publiés le 7 octobre, ont permis d'atteindre une amélioration de 5,3 fois du débit pour les charges de travail agentiques, et un gain de vitesse de 1,9 fois à faible concurrence. C'est colossal. Nous n'avons pas vu un tel bond en avant depuis longtemps sur un modèle de cette envergure.
Ces gains proviennent de plusieurs innovations techniques. Il y a eu l'implémentation du 'SWA bounded replay' avec des CUDA graphs, réduisant le 'Time To First Token' (TTFT) d'environ 30%. DeepSeek a également publié de nouveaux kernels optimisés (MegaAttention, Mega-mHC, Mega-Gate, DeepSelect) qui ont été intégrés. Sans oublier l'agressive fusion et parallélisation des kernels restants. Ces optimisations sont le fruit d'une compréhension profonde de l'architecture CED (Causal-Encoder-Decoder) asymétrique de V4.1-Flash, qui n'active que 8 milliards de paramètres pendant le préremplissage et 16 milliards pendant le décodage. Cette conception favorise intrinsèquement les tâches gourmandes en entrée, typiques des agents.
L'impact sur nos déploiements est direct. Nous pouvons désormais faire tourner des agents d'IA beaucoup plus complexes, gérant des volumes de données plus importants, avec une latence réduite et une consommation de ressources maîtrisée. Là où nous devions parfois arbitrer entre la taille du contexte et la réactivité, DeepSeek-V4.1-Flash sur vLLM nous offre les deux. C'est une libération technique. Ces avancées confirment nos analyses initiales, notamment celles que nous avons partagées dans DeepSeek-V4.1-Flash : L'Analyse Post-Lancement Qui Bouleverse l'Inférence Locale et l'Agentique d'Entreprise et DeepSeek-V4.1-Flash : Le Nouveau Champion de l'Inférence Locale et de l'Agentique d'Entreprise ?.
L'Efficacité Mémoire et Coût : Un Atout Inestimable
Au-delà de la vitesse pure, l'efficacité mémoire de DeepSeek-V4.1-Flash est un game changer. Son empreinte KV cache, à seulement 890 octets par token, est remarquablement faible. Cela est dû à des techniques comme le Compressed Sparse Attention 2 (CSA2), le cache KV en FP4 et le partage de cache KV inter-couches. Pour nos clients, cela signifie que nous pouvons déployer des agents sur du matériel moins cher, avec moins de VRAM, ou faire tourner plus d'agents en parallèle sur la même infrastructure. Les coûts d'inférence, souvent le talon d'Achille des déploiements d'IA, sont drastiquement réduits. DeepSeek a même retiré son modèle V4 Pro, quatre fois plus cher, redirigeant son trafic vers V4.1-Flash. Cela prouve leur confiance dans la performance de ce modèle plus petit et plus économique.
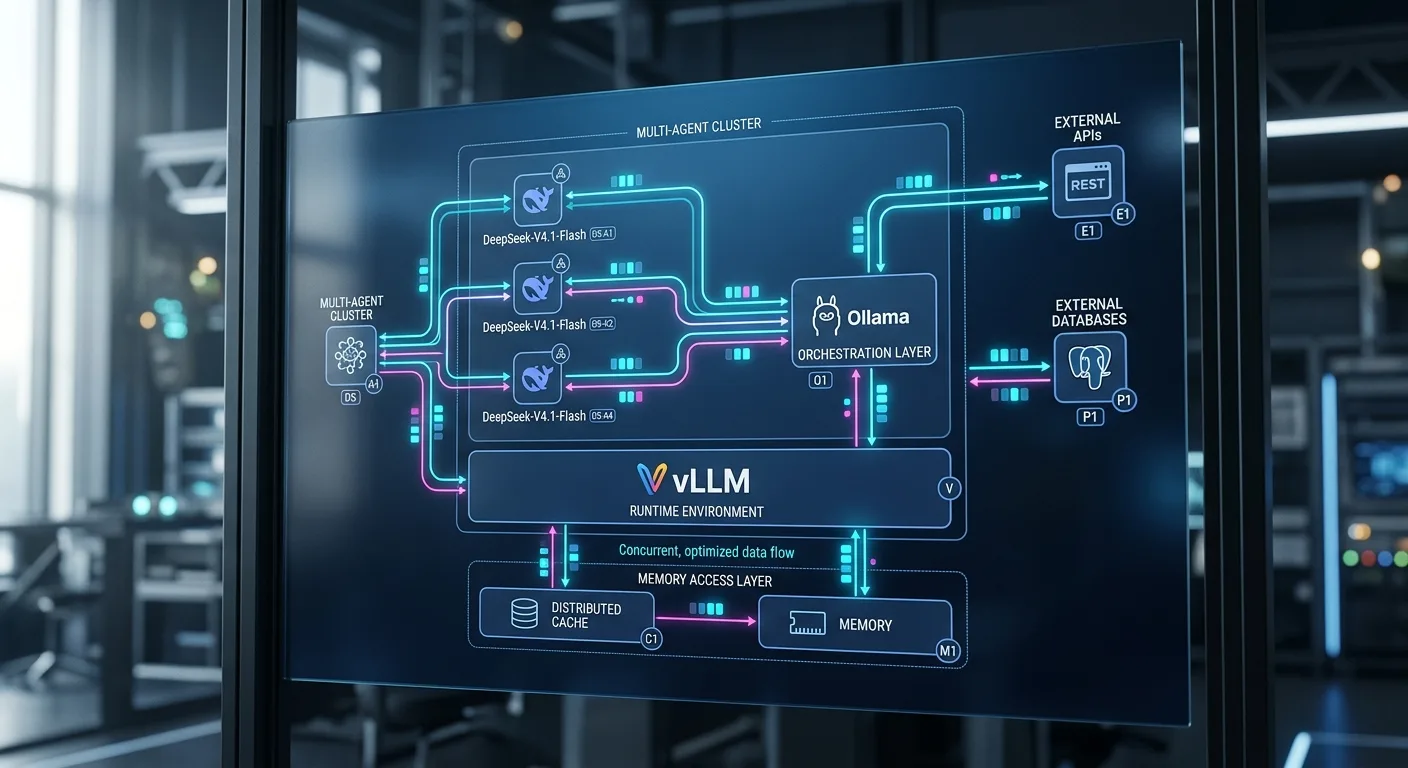
Les benchmarks récents, notamment sur LiveBench, montrent que DeepSeek-V4.1-Flash réduit l'écart entre l'IA chinoise et américaine à seulement 3%, dépassant même les modèles d'Anthropic sur les sous-benchmarks de codage agentique. Ces chiffres, publiés le 5 octobre, sont une validation externe forte de la puissance du modèle. Pour nous, c'est la preuve que la course à la puissance brute n'est pas la seule voie. L'optimisation architecturale et logicielle peut faire des miracles.
Ollama v0.40.1 : Des Fondations Locales Toujours Plus Solides
L'écosystème d'inférence locale ne serait pas ce qu'il est sans des outils comme Ollama. La version 0.40.1, fraîchement sortie le 8 octobre, apporte son lot d'améliorations continues. Bien que cette mise à jour soit davantage axée sur la stabilité et l'expérience utilisateur (corrections de l'interface macOS, gestion des téléchargements de modèles MLX, gestion des paramètres dépréciés), elle s'inscrit dans une dynamique d'amélioration constante qui rend le déploiement de modèles comme DeepSeek-V4.1-Flash toujours plus simple et fiable. Nous avions déjà mis en lumière l'importance d'Ollama dans Ollama v0.35.1 et les Modèles de Décision Clef : La Nouvelle Ère des Agents Locaux Intelligents.
Les avancées d'Ollama en matière de compatibilité API, notamment avec OpenAI Chat Completions et Anthropic Messages API, (annoncées fin septembre) sont également cruciales. Elles permettent à nos équipes d'utiliser des outils et des frameworks existants, conçus initialement pour les LLMs cloud, directement avec des modèles locaux via Ollama. Cette interopérabilité est un accélérateur de développement fantastique. Elle réduit la courbe d'apprentissage et facilite l'intégration de l'IA locale dans des infrastructures logicielles préexistantes. C'est un pas de plus vers une standardisation de l'accès aux modèles, qu'ils soient locaux ou cloud.
Ces mises à jour, bien que parfois discrètes, sont essentielles pour la robustesse des architectures multi-agents que nous concevons. Une meilleure gestion des modèles, une API plus stable, une compatibilité accrue : ce sont les fondations sur lesquelles nous bâtissons des systèmes d'automatisation avancée pour nos clients. La synergie entre un modèle de pointe comme DeepSeek-V4.1-Flash et un runtime performant comme Ollama est la clé de voûte de notre approche d'agentique d'entreprise.
L'Impact Concret sur les Architectures d'Agents d'Entreprise
Nous l'avons toujours affirmé : l'IA doit être un levier de performance concret, pas une boîte noire coûteuse. Les avancées récentes de DeepSeek-V4.1-Flash et d'Ollama viennent valider cette vision. Pour nos clients, cela signifie la possibilité de déployer des agents autonomes qui gèrent des processus métiers complexes – de l'analyse financière à la gestion de la relation client – sans compromettre la confidentialité des données ni les budgets. Fini l'envoi systématique de données sensibles vers des APIs cloud dont on ne maîtrise pas toujours le cycle de vie ou la localisation des serveurs.
Nous observons une accélération significative dans la mise en production de nos agents. La capacité du modèle à comprendre et à exécuter des appels d'outils complexes, combinée à l'efficacité de vLLM, nous permet de construire des boucles de rétroaction plus rapides et plus fiables. Un agent capable de consulter une base de données interne (PostgreSQL par exemple), d'interagir avec un CRM via une API REST, et de synthétiser une réponse personnalisée en temps quasi réel, c'est la promesse tenue de l'agentique locale. Nous avons d'ailleurs exploré les défis et opportunités de cette approche dans Google Workspace : L'Agentique d'Entreprise Prend une Nouvelle Dimension avec les Skills et Gemini 3.8 Live, où la comparaison avec les solutions cloud est inévitable.
De la Théorie à la Pratique : Cas d'Usage Réels
Sur le terrain, ces améliorations se traduisent par des gains tangibles. Prenons un agent de conformité : il doit ingérer des milliers de documents réglementaires, identifier des clauses spécifiques et alerter sur les risques potentiels. La gestion du contexte d'un million de tokens de DeepSeek-V4.1-Flash, optimisée par vLLM, permet de traiter ces documents en bloc, sans fragmentation, garantissant une analyse plus cohérente et moins sujette aux erreurs d'interprétation. La rapidité d'exécution signifie que les analyses peuvent être effectuées plus fréquemment, offrant une veille réglementaire quasi en temps réel. C'est un avantage concurrentiel majeur pour les entreprises soumises à des contraintes réglementaires fortes.
Un autre exemple est l'agent de développement logiciel. Capable de lire des bases de code entières, de comprendre le contexte d'un projet, de générer du code, de le tester et même de proposer des correctifs. Les performances accrues en débit pour les tâches agentiques sont directement bénéfiques ici. L'agent peut itérer plus rapidement sur les propositions, réduisant les cycles de développement et augmentant la productivité des équipes. Nous utilisons ces modèles pour augmenter nos propres ingénieurs, pas pour les remplacer. C'est une augmentation de capacité, pas une substitution.
Défis et Perspectives : Rester Vigilants
Malgré ces avancées spectaculaires, nous restons lucides. L'inférence locale demande toujours un investissement initial en hardware. Bien que le coût des GPUs soit en baisse et que l'efficacité logicielle progresse, toutes les entreprises ne sont pas équipées pour héberger des modèles de cette taille. C'est un arbitrage que nous réalisons avec chaque client, en pesant le TCO (Total Cost of Ownership) par rapport aux solutions cloud. Le contrôle total sur les données et la réduction des latences sont souvent des arguments de poids, mais la maturité de l'infrastructure IT interne reste un facteur déterminant.
La sécurité des systèmes d'IA est une autre préoccupation constante. Les vulnérabilités liées au RAG (Retrieval Augmented Generation) ou aux injections de prompts sont des menaces réelles, même en local. Nous développons des stratégies de défense robustes, des filtres en entrée/sortie et des architectures de sécurité multicouches pour protéger nos systèmes et les données de nos clients. La conformité avec l'EU AI Act, par exemple, exige une traçabilité et une explicabilité rigoureuses des décisions des agents, ce qui est parfois plus facile à garantir sur des déploiements que nous maîtrisons de bout en bout.
L'écosystème open source est dynamique, parfois chaotique. De nouveaux modèles, de nouvelles versions, apparaissent chaque semaine. Notre rôle chez Astoïk est de faire cette veille, de tester, d'évaluer et d'intégrer les briques les plus pertinentes pour nos architectures. DeepSeek-V4.1-Flash est aujourd'hui un champion, mais nous continuons de surveiller des acteurs comme Mistral, Meta Llama, ou Qwen, car la prochaine innovation peut surgir à tout moment.
Conclusion : L'Autonomie IA est à Portée de Main
Les nouvelles des dernières 48 heures confirment une tendance de fond : l'IA locale, performante et souveraine, est une réalité. Les optimisations de DeepSeek-V4.1-Flash sur vLLM, couplées aux avancées d'Ollama, nous donnent les moyens de construire des systèmes d'agents autonomes d'une puissance et d'une efficacité inégalées. Pour les entreprises qui cherchent à maîtriser leurs données, leurs coûts et leur stack technologique, c'est une opportunité historique. Chez Astoïk, nous sommes prêts à accompagner nos clients dans cette révolution, en transformant ces innovations techniques en solutions métiers concrètes et impactantes. L'avenir de l'IA est local, et il est plus prometteur que jamais.
Besoin d'avancer sur ce sujet ?
Discutons de vos enjeux spécifiques lors d'un audit informel.
Lou Chardin
Head of Product
Conçoit les architectures de données et les OS métiers IA d'Astoïk. Passionné par l'intégration pratique de l'IA générative.
Profil LinkedIn