
DeepSeek-V4.1-Flash et vLLM : Le Débit Agentique Multiplié Par Cinq Redéfinit l'Inférence Locale
L'écosystème de l'IA open source bouge à une vitesse folle. La synergie entre DeepSeek-V4.1-Flash et vLLM vient de franchir un cap majeur, transformant radicalement les capacités de l'inférence locale pour les systèmes agentiques. Nous parlons ici d'une multiplication par cinq du débit, une avancée qui change la donne pour nos déploiements en entreprise.
L'urgence de l'inférence locale performante pour l'entreprise
Chez Astoïk, nous observons depuis des mois une tension croissante chez nos clients. Ils veulent exploiter la puissance des grands modèles de langage, c'est évident. Mais la dépendance aux APIs tierces, avec leurs coûts fluctuants, leurs latences imprévisibles et, surtout, les enjeux de souveraineté des données, devient un frein. L'inférence locale n'est plus une option, c'est une nécessité stratégique. Le constat est net. Pendant des mois, nous avons contourné le problème avec des scripts fragiles ou des architectures hybrides complexes. L'objectif est clair : amener la puissance de l'IA au plus près des données métier, sur l'infrastructure de nos clients. Cela passe par des modèles performants, mais aussi par des moteurs d'inférence capables de les exploiter à plein régime.
Le défi a toujours été d'égaler la performance et la flexibilité des solutions cloud avec des environnements on-premise. Cela demande des innovations constantes sur les modèles eux-mêmes, mais aussi sur la manière dont ils sont servis. C'est là que les annonces récentes autour de DeepSeek-V4.1-Flash et vLLM prennent toute leur saveur, car elles apportent des réponses concrètes à ces problématiques.
DeepSeek-V4.1-Flash et vLLM : Le duo choc de l'agentique locale
L'actualité brûlante de ces derniers jours, c'est l'optimisation spectaculaire de DeepSeek-V4.1-Flash avec le framework d'inférence vLLM. Inferact et la communauté vLLM ont publié des résultats qui parlent d'eux-mêmes : une amélioration du débit de 5,3 fois sous une contrainte de 150 requêtes par seconde (TPS) et une accélération de 1,9 fois pour les faibles concurrences. C'est une révolution pour quiconque cherche à déployer des LLMs performants en local, surtout pour les applications agentiques. DeepSeek-V4.1-Flash, publié le 10 septembre 2026 sous licence MIT, est déjà un modèle impressionnant avec ses 552 milliards de paramètres au total, activant 8 milliards à l'entrée et 16 milliards à la sortie, et une fenêtre de contexte d'un million de tokens. Ce modèle intègre également une prise en charge native de la multimodalité, acceptant des images directement dans les appels d'API. Cela ouvre des portes à des cas d'usage complexes où le traitement visuel est intégré aux raisonnements textuels, sans passer par des étapes d'OCR ou des APIs de vision séparées. Fini les intégrations bancales pour analyser des documents scannés ou des captures d'écran. Tout se passe dans le même appel, simplifiant drastiquement nos architectures et réduisant les points de défaillance. Nous en parlons dans nos analyses sur l'inférence locale réinventée avec DeepSeek-V4.1-Flash et vLLM, qui expliquent comment le débit agentique explose.
Le framework vLLM, quant à lui, est devenu un standard de facto pour l'inférence haute performance sur GPU grâce à ses techniques innovantes comme le PagedAttention. Sa capacité à gérer efficacement le KV cache et à optimiser l'utilisation du GPU est ce qui permet de tirer le meilleur parti de modèles comme DeepSeek-V4.1-Flash. Sans un moteur d'inférence aussi robuste, même le meilleur des modèles resterait sous-exploité sur nos machines.
Sous le capot : Les optimisations qui changent tout
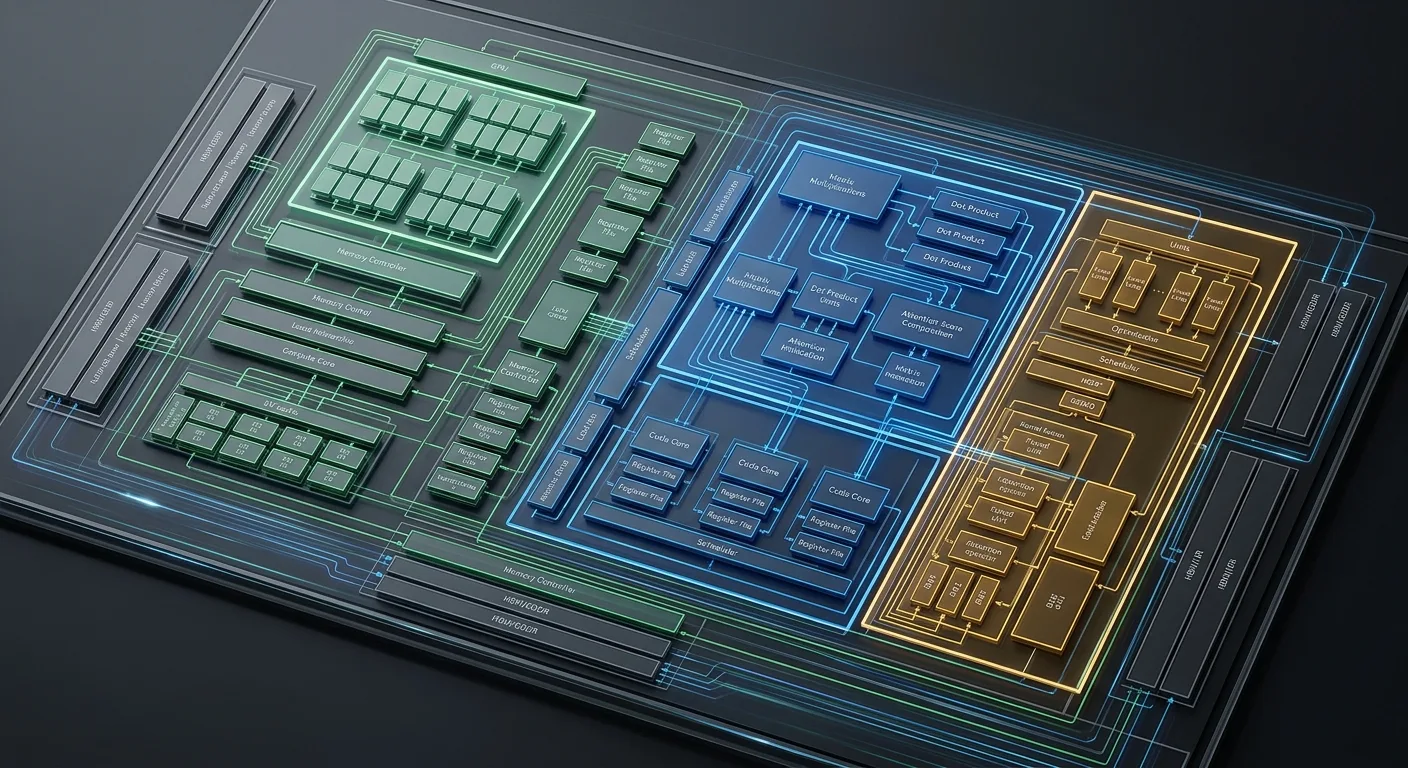
Les gains de performance ne sortent pas de nulle part. Ils sont le fruit d'un travail d'ingénierie profond, touchant à l'architecture du modèle et aux optimisations du runtime. Voici les points clés que nous avons identifiés:
- SWA Bounded Replay : DeepSeek-V4.1 introduit le SWA (Sliding Window Attention) bounded replay. Cette technique permet de ne recalculer qu'une partie limitée du contexte (les 128 derniers tokens) lors de la relecture, au lieu de reconstruire l'intégralité de la fenêtre. Cela réduit considérablement le temps de préremplissage (prefill computation time) de 30 à 40%, avec une perte de qualité négligeable, comme nous l'avons vérifié sur des benchmarks tels que GSM8K et GPQA. C'est une astuce géniale qui réduit la charge de calcul sans sacrifier la pertinence des réponses.
- CUDA Graphs pour les couches tronquées : L'intégration des CUDA graphs permet de maintenir la rapidité des petites relectures tronquées sur le GPU, évitant ainsi les goulots d'étranglement liés aux lancements de kernels CPU. Le résultat est une accélération significative, particulièrement pour le Time To First Token (TTFT).
- Nouveaux Kernels DeepSeek : L'intégration des kernels récemment publiés par DeepSeek, notamment MegaAttention, Mega-mHC, Mega-Gate et DeepSelect, est cruciale. Ces kernels sont optimisés pour l'architecture spécifique de DeepSeek et sont fusionnés agressivement dans vLLM, ce qui améliore l'efficacité des calculs. Le Mega-mHC, par exemple, fusionne la chaîne mHC en un seul kernel, surpassant les implémentations précédentes.
- Optimisation du KV Cache : DeepSeek-V4.1-Flash est extrêmement économe en mémoire. Il utilise des techniques comme le Compressed Sparse Attention 2 (CSA2), le KV cache FP4 et le partage du KV cache inter-couches. La taille du KV cache global est réduite à seulement 890 octets par token, soit un quart de la version précédente V4-Flash. Cela signifie qu'un prompt d'un million de tokens tient dans moins d'un Go de KV cache global, un exploit technique qui débloque des contextes longs sans faire exploser la VRAM. C'est un point critique pour la rentabilité des déploiements locaux.
- Architecture Causal Encoder-Decoder (CED) : Le modèle active 16 milliards de paramètres par token pendant le décodage, mais seulement 8 milliards pendant le préremplissage. Cette architecture asymétrique est conçue pour l'efficacité des tâches de serving agentique à long horizon, où la majeure partie du calcul est consacrée à la génération plutôt qu'à la compréhension initiale.
Ces avancées ne sont pas juste des chiffres de benchmark. Elles se traduisent par une réduction drastique de la latence et une augmentation massive du débit, ce qui est directement perceptible sur nos déploiements. On peut en dire plus sur la manière dont le débit agentique s'envole avec ces innovations.
Le Débit Agentique : Une métrique clé pour l'entreprise
Le terme 'débit agentique' est devenu central dans nos discussions. Il ne s'agit plus seulement de savoir combien de tokens un modèle peut générer par seconde, mais combien de 'tours' d'agent, combien de boucles de réflexion et d'action, un système peut accomplir dans un laps de temps donné. Une augmentation de 5x du débit sous forte charge, c'est la différence entre un système d'agents qui rame et un système fluide, capable de gérer des centaines de tâches simultanément. Pour les entreprises, cela signifie des processus métier automatisés beaucoup plus réactifs, des assistants IA qui ne font pas attendre les utilisateurs, et une capacité à traiter des volumes de données sans précédent directement sur leurs serveurs.
Imaginez un agent qui doit interroger une base de données, analyser des documents, interagir avec un CRM, puis générer un rapport. Chaque étape est une requête à un LLM. Si chaque requête est rapide et que le système peut enchaîner les étapes sans latence excessive, la valeur business explose. C'est précisément ce que ces optimisations permettent. Les coûts d'API sont éliminés, la confidentialité des données est assurée, et le contrôle total de l'infrastructure revient à l'entreprise. Nous avons d'ailleurs exploré comment DeepSeek-V4.1-Flash se positionne comme un champion de l'inférence locale et de l'agentique d'entreprise.
L'impact matériel : NVIDIA Vera Rubin et au-delà
Ces avancées logicielles sont intimement liées aux progrès matériels. vLLM a récemment annoncé un support optimisé pour la plateforme NVIDIA Vera Rubin NVL72, atteignant jusqu'à 7,8 fois le débit du GB200 NVL72 sur des benchmarks comme SemiAnalysis AgentX, en utilisant des modèles comme MiniMax M3. Vera Rubin offre une bande passante HBM 2,4 fois supérieure et une bande passante NVLink bidirectionnelle 1,7 fois supérieure, sans parler des performances FP4 FLOPS multipliées par cinq. C'est une synergie essentielle : des modèles optimisés, des moteurs d'inférence hyper-efficaces, et un hardware de pointe. Cela signifie que les entreprises qui investissent dans ces nouvelles générations de GPU verront leurs capacités d'IA locale décuplées. Le 'Day-0 usability' de vLLM sur Vera Rubin est un point crucial, permettant aux utilisateurs d'exploiter immédiatement ces cartes avec des images nightly Docker, et le support de modèles divers comme DeepSeek, Kimi, GLM et MiniMax est déjà en place. Les kernels spécifiques à Rubin, pour l'attention, le GEMM et le MoE (Mixture of Experts), sont progressivement intégrés via des bibliothèques comme FlashInfer, augmentant encore les performances.
Cette course à l'armement entre le logiciel et le matériel est fascinante. Chaque avancée sur l'un pousse l'autre à se dépasser. Pour nos clients qui déploient des architectures complexes, cette convergence est une aubaine, car elle rend l'IA de pointe accessible et maîtrisable. Nous avons aussi vu des avancées du côté d'Ollama avec sa version v0.35.1, qui permet jusqu'à dix recherches web par réponse et des mises à jour des versions MLX et llama.cpp, ce qui est très pertinent pour les agents locaux intelligents et les modèles de décision. La nouvelle ère des agents locaux intelligents est clairement là.
Au-delà de la performance brute : Multimodalité et décision
L'actualité ne se limite pas à la vitesse d'inférence. Elle touche aussi à la richesse fonctionnelle des modèles. DeepSeek-V4.1-Flash se distingue par son support multimodal natif, acceptant les images directement dans les appels de complétion de chat. Pour nous, cela simplifie énormément la création de solutions d'analyse documentaire, de QA visuel, ou d'agents capables de comprendre un contexte visuel et textuel simultanément. Plus besoin d'orchestrer des pipelines complexes avec des modèles de vision séparés, ce qui réduit la latence et la complexité de développement. C'est une avancée majeure pour les applications d'entreprise qui traitent des informations hétérogènes.
Parallèlement, vLLM Semantic Router a lancé Decision 3.0, une famille de modèles de décision multimodaux sous Apache-2.0. Ces modèles peuvent lire du texte, du JSON et des images, puis répondre à des questions typées. C'est un outil puissant pour les développeurs, offrant un moyen rapide de classer, router et filtrer les requêtes sans avoir à parser le texte généré. Les modèles Decision 3.0, allant de 0.8B à 27B, montrent que même les plus petits modèles peuvent surpasser les générations précédentes sur certaines tâches, avec le d3-flash (9B) battant des modèles 27B de l'ancienne génération. Pour l'orchestration d'agents autonomes, c'est un atout indéniable, permettant des décisions plus fines et plus rapides au sein d'une architecture multi-agents. Nous suivons de près les développements concernant les agents universels et les 'skills', comme nous l'avons analysé avec Google Gemini à Work 2026, et ces modèles de décision s'inscrivent parfaitement dans cette dynamique.
Notre vision chez Astoïk : Réalités du terrain et perspectives
Ces annonces ne sont pas que des lignes sur un benchmark. Elles ont un impact direct sur la manière dont nous concevons et déployons les solutions d'IA chez Astoïk. Sur nos déploiements, nous voyons que le DeepSeek-V4.1-Flash, couplé à vLLM, permet enfin aux PME de se doter de capacités IA avancées sans exploser leur budget cloud ou compromettre la confidentialité de leurs données. C'est une opportunité unique pour démocratiser l'IA de pointe. Nous ne nous contentons pas de lire les chiffres, nous les testons, nous les poussons dans leurs retranchements avec des charges réelles chez nos clients. Ce que l'on observe sur le terrain, c'est une réduction significative des coûts de calcul et une augmentation de la réactivité des systèmes. Cela est d'autant plus vrai avec des architectures optimisées pour le Tensor Parallelism (TP) et des cartes comme les H200 ou les nouvelles Vera Rubin, où le DeepSeek-V4.1-Flash peut tenir sur des configurations de TP4 ou TP8 avec une VRAM suffisante pour un KV cache conséquent.
Cependant, il ne faut pas se voiler la face. Le déploiement local reste un défi technique. Il demande une expertise en infrastructure GPU, en optimisation de kernels, et en gestion de la mémoire VRAM. Les exigences matérielles restent importantes. Un modèle comme DeepSeek-V4.1-Flash, même avec ses optimisations, nécessite une planification rigoureuse de la capacité. La taille du checkpoint est d'environ 511 Go sur disque, et il faut prévoir une VRAM minimale d'environ 614 Go pour le charger avec une marge pour le KV cache. Cela signifie que même si les coûts d'inférence par token diminuent drastiquement, l'investissement initial en hardware peut être conséquent. Nous accompagnons nos clients pour faire ces choix, en évaluant le rapport coût/bénéfice et en construisant des architectures robustes et évolutives.
La feuille de route de vLLM pour le quatrième trimestre 2026, avec des discussions sur le raffinement des mises à jour de poids, la conception de connecteurs auxiliaires et l'intégration de frameworks RL, montre que l'innovation ne s'arrête pas là. Le support pour les modèles frontières comme DeepSeek V4.1, GLM 5.3 et Qwen3.8 continue d'être une priorité. Nous attendons avec impatience les prochaines versions, qui promettent encore plus d'efficacité et de nouvelles capacités pour les systèmes d'IA autonomes. L'ère de l'IA locale, performante et souveraine, est bel et bien là. Et nous sommes en première ligne pour la construire.
Lou Chardin, Head of Product et architecte technique chez Astoïk
Besoin d'avancer sur ce sujet ?
Discutons de vos enjeux spécifiques lors d'un audit informel.
Lou Chardin
Head of Product
Conçoit les architectures de données et les OS métiers IA d'Astoïk. Passionné par l'intégration pratique de l'IA générative.
Profil LinkedIn