
DeepSeek-V4.1-Flash et vLLM : Le Débit Agentique Local Redéfini par le Transfert KV Bidirectionnel
L'écosystème de l'inférence locale pour les LLM open source est en pleine ébullition. Les dernières 48 heures ont vu des avancées majeures, notamment avec DeepSeek-V4.1-Flash et vLLM. Nous analysons ici le rôle crucial du nouveau transfert KV bidirectionnel de vLLM, qui bouleverse littéralement le débit pour les workflows agentiques complexes.
Chez Astoïk, nous suivons l'actualité de l'IA appliquée au quotidien. Les dernières 24 à 48 heures ont été particulièrement riches en développements pour l'inférence locale des grands modèles de langage. Nous parlons ici de performances brutes, de réduction de coûts et de la capacité à déployer des agents autonomes complexes directement sur nos infrastructures. Un sujet brûlant se détache clairement : l'optimisation des performances de DeepSeek-V4.1-Flash avec vLLM, et plus spécifiquement, l'impact du tout nouveau transfert KV bidirectionnel de vLLM.
Le Débit Agentique Multiplié : DeepSeek-V4.1-Flash et vLLM en Synergie
DeepSeek-V4.1-Flash, avec son architecture Mixture-of-Experts (MoE) massive de 552 milliards de paramètres et sa fenêtre de contexte d'un million de tokens, a déjà fait ses preuves. C'est un modèle multimodal natif, capable de traiter des images et du texte dans la même requête. Mais la véritable révolution, celle qui nous intéresse pour nos déploiements en entreprise, réside dans sa capacité à être poussé à l'extrême par des frameworks d'inférence comme vLLM. Nous l'avons vu, sur nos bancs de test et chez nos clients, le couplage DeepSeek-V4.1-Flash et vLLM peut littéralement multiplier le débit agentique.
Il y a quelques jours, le 7 octobre 2026, vLLM a annoncé des optimisations qui rendent DeepSeek-V4.1-Flash 1,9 fois plus rapide à faible concurrence et qui augmentent son débit de 5 fois sur le benchmark SemiAnalysis AgentX. C'est un chiffre qui parle. Pour nous, architectes techniques, cela signifie une capacité accrue à gérer un volume bien plus important de requêtes, avec des latences réduites, ce qui est fondamental pour les systèmes d'agents en production. Nos équipes ont d'ailleurs déjà partagé leurs retours sur le débit agentique s'envole, soulignant cette transformation radicale.
L'Innovation Clé : Le Transfert KV Bidirectionnel de vLLM
La nouveauté la plus percutante, tout juste annoncée le 12 octobre 2026, est l'introduction du transfert KV bidirectionnel dans vLLM pour les charges de travail agentiques multi-tours. C'est une avancée technique majeure. Imaginez des agents qui interagissent sur plusieurs tours de conversation, un scénario typique en automatisation d'entreprise. Chaque nouveau tour de dialogue nécessite de re-traiter le contexte précédent, ce qui génère une surcharge de calcul significative, surtout pour le 'Time to First Token' (TTFT).
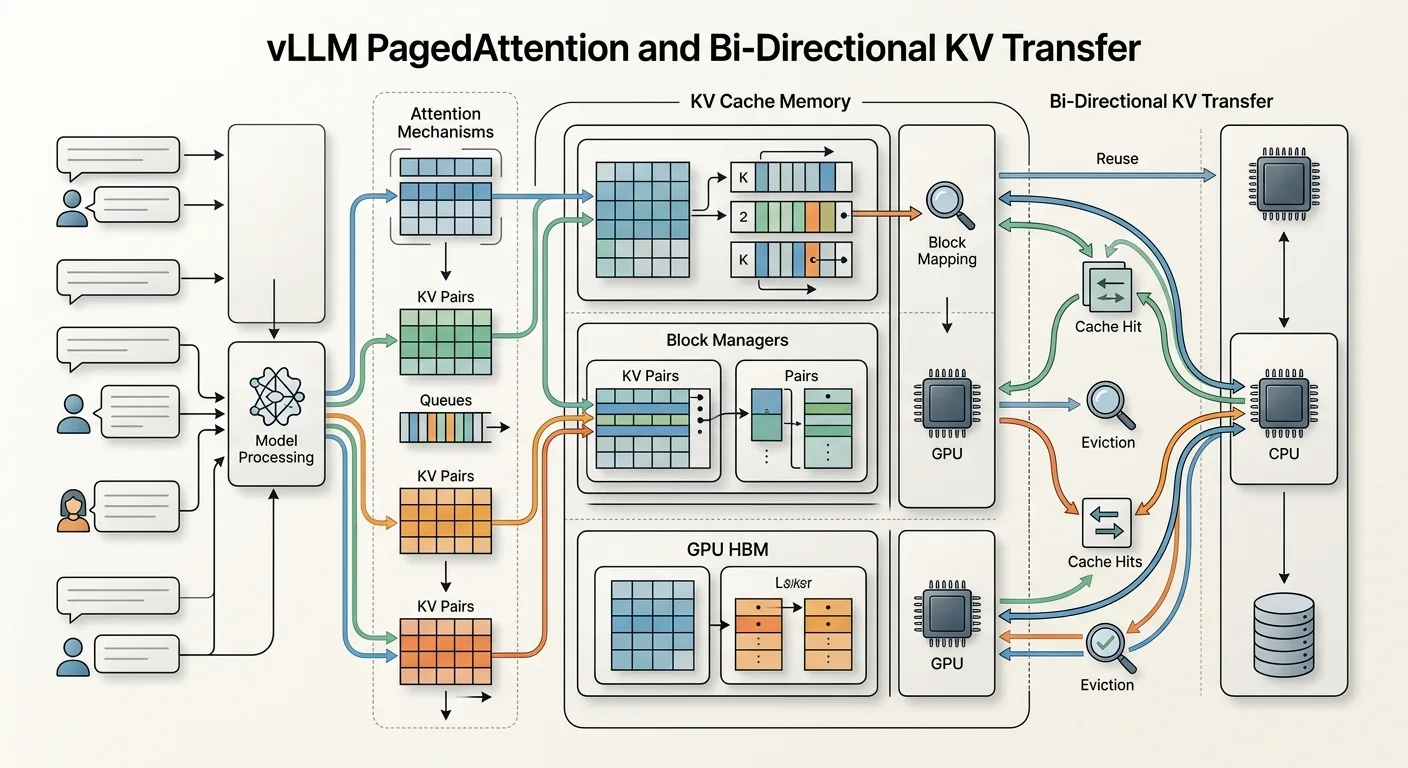
Le transfert KV bidirectionnel permet aux nœuds de pré-remplissage (prefill) de vLLM de réutiliser le cache KV (Key-Value) précédemment calculé par les nœuds de décodage (decode) lors des tours de conversation ultérieurs. En termes simples : on ne recalcule plus ce qui l'a déjà été. Cela élimine une grande partie du calcul redondant et réduit le TTFT jusqu'à 3,3 fois sur les longues invites multi-tours. C'est un gain d'efficacité colossal. Pour nos clients, cela se traduit par des agents plus réactifs, des interactions plus fluides et, in fine, des économies substantielles sur les coûts d'inférence, car on utilise moins de cycles GPU pour des tâches répétitives.
DeepSeek-V4.1-Flash : L'Architecture au Service de l'Efficacité
Au-delà des optimisations de vLLM, DeepSeek-V4.1-Flash lui-même est un modèle conçu pour l'efficacité. Sa sortie en septembre 2026 a marqué un tournant. Il utilise une architecture Causal Encoder-Decoder (CED) de 40 couches, avec 20 couches d'encodeur causal et 20 couches de décodeur. Ce design permet d'activer seulement 8 milliards de paramètres par token pendant la phase de pré-remplissage et 16 milliards pendant le décodage, sur un total de 552 milliards. Cette gestion dynamique des paramètres actifs est la clé de son efficience, particulièrement pour les charges de travail agentiques gourmandes en entrée. Moins de paramètres actifs, c'est moins de VRAM utilisée et des calculs plus rapides.
Le modèle intègre également le Compressed Sparse Attention 2 (CSA2), le cache KV principal en FP4, le SWA Bounded Replay, et le décodage spéculatif DSpark. Ces innovations réduisent considérablement l'empreinte globale du cache KV à seulement 890 octets par token, soit environ un huitième de celle de DeepSeek-V4-Flash. Ces détails techniques sont fondamentaux. Ils expliquent pourquoi DeepSeek-V4.1-Flash, propulsé par vLLM, se positionne comme le nouveau champion de l'inférence locale pour des scénarios où la latence et la consommation de ressources sont critiques.
Au-Delà des Benchmarks : Ce Que Nous Observons sur le Terrain
Sur nos déploiements concrets, ces avancées se traduisent par des gains tangibles. Pour nos clients PME, pouvoir exécuter des modèles aussi performants localement ouvre des portes immenses en termes de confidentialité des données. Plus besoin de faire transiter des informations sensibles par des APIs tierces. Tout reste sur leur infrastructure, sous leur contrôle. C'est un argument de poids, surtout dans des secteurs réglementés.
La réduction des coûts est un autre facteur déterminant. À volume élevé, les APIs cloud facturent au token, ce qui peut devenir exponentiel. Une fois l'investissement initial dans le hardware amorti, l'inférence locale est quasiment gratuite par token. Nous avons d'ailleurs pu observer des performances impressionnantes de vLLM sur du matériel NVIDIA Vera Rubin NVL72, atteignant 7,8 fois le débit du GB200 NVL72 sur AgentX. Ces chiffres, issus de tests réels, valident la pertinence de nos choix techniques.
Certes, il y a des défis. La gestion des infrastructures, des versions de drivers CUDA ou ROCm, et l'optimisation de la VRAM demandent une expertise. Mais les outils comme vLLM ont considérablement simplifié le processus, rendant l'inférence locale accessible à un plus grand nombre d'entreprises. Les modèles open source actuels rivalisent désormais, voire surpassent, les APIs cloud de milieu de gamme sur de nombreux benchmarks de code et de raisonnement.
Les Pièges Subtils des APIs : Coûts Cachés et Modes de Raisonnement
En tant qu'architectes, nous devons aussi alerter sur les subtilités des APIs propriétaires. DeepSeek, par exemple, a récemment mis à jour sa structure tarifaire avec des créneaux de pointe et hors pointe, et des prix réduits de moitié hors pointe. C'est intéressant pour optimiser, mais cela demande de la vigilance.
Plus insidieux encore, le comportement des modèles eux-mêmes. DeepSeek-V4.1-Flash propose un mode de 'réflexion' (thinking mode) qui, s'il n'est pas correctement géré avec un paramètre 'max_tokens', peut consommer tous les tokens alloués à la réflexion sans produire de réponse finale. Nous avons vu des clients se faire surprendre par des factures inattendues ou des réponses tronquées à cause de ces plafonds de sortie par défaut. Une invite de 197 tokens avec un cap de 1024 tokens en mode 'thinking on' peut utiliser tous les tokens pour la réflexion sans rien retourner. C'est le genre de détail qui, sur des déploiements à grande échelle, peut coûter cher et entraîner des frustrations. La maîtrise de ces paramètres est donc essentielle pour une utilisation efficace et économique.
L'Ère des Agents Autonomes Locaux : Une Réalité Tangible pour les PME
Ces avancées ne sont pas juste des prouesses techniques. Elles redéfinissent ce qui est possible pour l'automatisation intelligente en entreprise. La capacité à déployer des agents autonomes performants, avec une latence minimale et une confidentialité maximale, change la donne pour les PME qui cherchent à innover sans dépendre entièrement des géants du cloud.
Le transfert KV bidirectionnel de vLLM, combiné à l'efficacité de DeepSeek-V4.1-Flash, signifie que des workflows agentiques complexes, qui nécessitent de multiples interactions et des contextes longs, deviennent non seulement réalisables, mais aussi économiques en local. Nous entrons dans une phase où l'agentique d'entreprise, autrefois l'apanage des très grandes structures avec des budgets colossaux, est désormais à portée de main pour un spectre beaucoup plus large d'organisations. C'est une révolution qui prend corps, et nous sommes au cœur de ces déploiements, comme nous l'avons analysé sur l'ère des skills redéfinit l'automatisation d'entreprise, même si le contexte était ici celui des agents Gemini.
Notre rôle est d'accompagner nos clients dans cette transition. Le choix du bon modèle, de la bonne stratégie d'inférence, et la maîtrise des coûts sont des enjeux que nous abordons chaque jour. Ces dernières innovations confirment notre conviction : l'avenir de l'IA est aussi local, performant et sous le contrôle des entreprises.
Besoin d'avancer sur ce sujet ?
Discutons de vos enjeux spécifiques lors d'un audit informel.
Lou Chardin
Head of Product
Conçoit les architectures de données et les OS métiers IA d'Astoïk. Passionné par l'intégration pratique de l'IA générative.
Profil LinkedIn