
DeepSeek-V4.1-Flash-1017 : Un Coup de Tonnerre pour l'Inférence Locale Agentique
La scène de l'IA open-source vient de vivre une secousse majeure avec le déploiement de DeepSeek-V4.1-Flash-1017. Cette nouvelle itération du modèle promet des performances d'inférence locale qui changent la donne, en particulier pour les architectures agentiques. Nous avons plongé dans les benchmarks et les retours terrain pour comprendre ce que cela signifie concrètement pour nos déploiements.
Chez Astoïk, notre quête constante de l'innovation nous pousse à scruter chaque avancée majeure dans l'écosystème de l'IA. Ces dernières 24 à 48 heures, une actualité a particulièrement retenu notre attention, faisant vibrer nos équipes techniques : la sortie du modèle DeepSeek-V4.1-Flash-1017. Ce n'est pas une simple mise à jour incrémentale, c'est une véritable déflagration pour l'inférence locale, surtout dans nos contextes d'agents autonomes. Cela nous confirme que la course à l'efficacité et à la performance sur les machines locales s'intensifie, ouvrant des perspectives inédites pour les entreprises qui cherchent à maîtriser leurs données et leurs coûts.
DeepSeek-V4.1-Flash-1017 : Les Détails Techniques Qui Comptent
DeepSeek a frappé fort avec cette version 1017 de son modèle V4.1-Flash, déployée le 19 octobre 2026. Ce que nous observons, c'est une optimisation agressive orientée vers la performance brute et la concision des réponses. L'objectif est clair : permettre aux modèles de s'exécuter plus vite, avec des outputs plus directs, ce qui est fondamental pour les boucles d'agents qui nécessitent une réactivité quasi instantanée.
Le modèle est désormais live sur l'API DeepSeek, mais l'information cruciale pour nous, c'est sa disponibilité en open-source sur Hugging Face et ModelScope. Cela signifie une accessibilité directe pour l'intégration dans nos infrastructures, sans les contraintes habituelles des APIs propriétaires. Nous pouvons le télécharger, l'optimiser, et le faire tourner sur nos propres serveurs. C'est la promesse d'une souveraineté technique accrue, un point que nous défendons ardemment chez Astoïk.
DeepSeek a également ouvert ses APIs Search & Fetch à tous, facturées à 0,75 $ pour 1 000 appels. C'est une stratégie intéressante pour capter les développeurs, mais notre focus reste sur l'exécution locale pour les cas d'usage critiques où la latence et la confidentialité des données sont primordiales. Les appels via DeepSeek Harness, Claude Code et Codex sont même gratuits jusqu'au 31 octobre 2026, une incitation claire à l'adoption de leur écosystème.
Les Benchmarks : Des Chiffres Éloquents pour l'Agentique
Parlons chiffres, car c'est là que DeepSeek-V4.1-Flash-1017 brille. Les scores sont impressionnants, montrant des gains substantiels par rapport à la version de septembre. Sur Humanity's Last Exam (sans outils), le modèle passe de 36,8 à 42,6. Sur Terminal-Bench 4.0, il bondit de 31,2 à 42,3. ProgramBench monte de 20,3 à 29,1, et DeepSWE v1.1 atteint 77,0, contre 74,2 précédemment.
Ces métriques ne sont pas anodines. Elles indiquent une amélioration significative de la capacité du modèle à raisonner, à coder et à exécuter des tâches agentiques. Pour nous, qui construisons des systèmes multi-agents complexes, un modèle qui excelle sur Terminal-Bench et DeepSWE est un atout majeur. Cela signifie que nos agents peuvent mieux comprendre les instructions, planifier des actions plus complexes et interagir avec des environnements de code avec une plus grande efficacité. Nous l'avons souvent souligné dans nos analyses, notamment pour l'inférence locale agentique, l'importance d'avoir des modèles robustes sur ces benchmarks est capitale. Vous pouvez retrouver nos réflexions sur ce sujet dans notre article DeepSeek-V4.1-Flash-1017 : L'Inférence Agentique Locale Prend un Vrai Coup de Boost, Ollama Suit le Pas.
La performance annoncée par Fireworks AI est tout simplement bluffante : plus de 1 521 tokens par seconde sur leur infrastructure Ultrafast, permettant de coder un Tetris en 11 secondes. C'est une vitesse qui redéfinit les attentes en matière d'inférence locale. Même si nous attendons de reproduire ces chiffres sur nos propres infrastructures, cela donne une idée du potentiel immense de ce modèle lorsqu'il est optimisé pour le débit.
vLLM et DeepSeek : Le Duo Gagnant de l'Inférence Locale
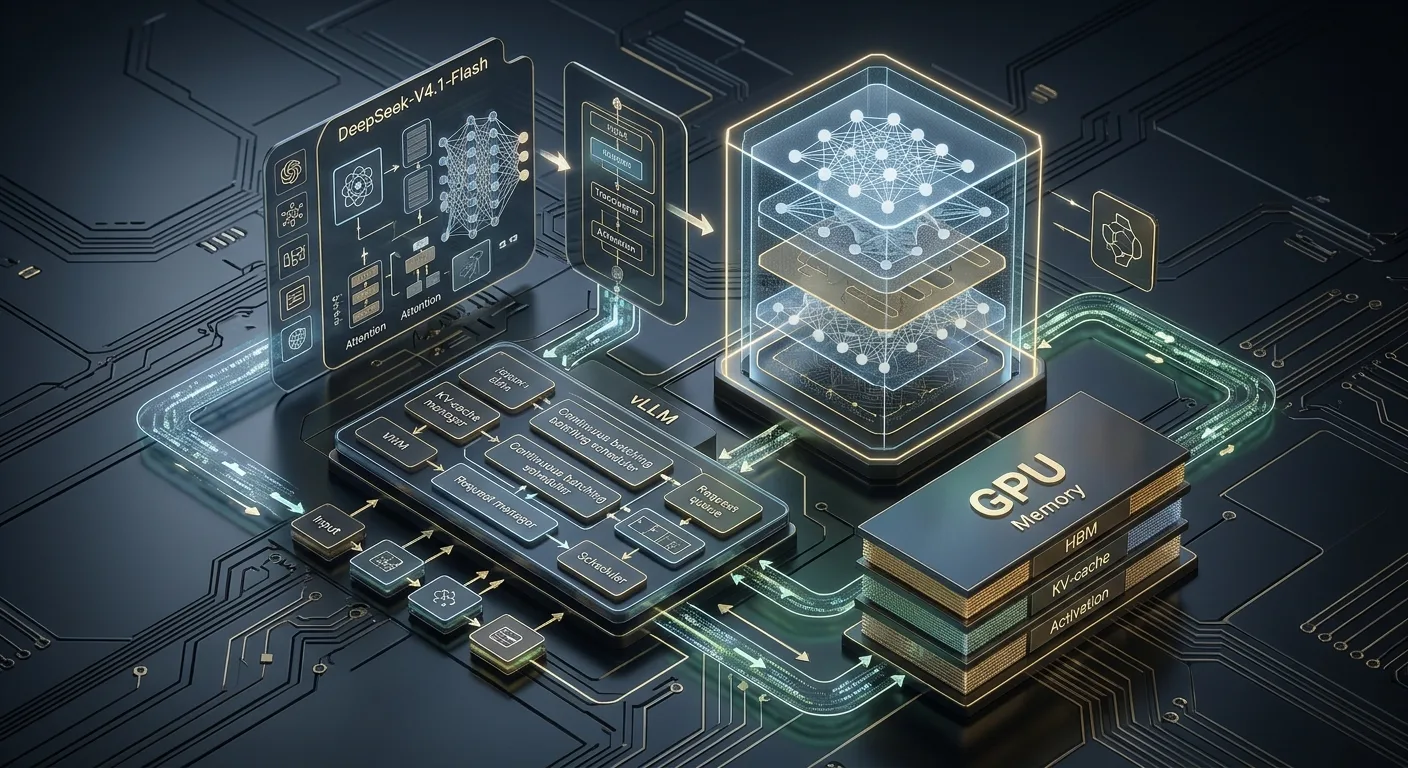
Ces performances ne seraient pas aussi accessibles sans des moteurs d'inférence comme vLLM. Nous le savons bien, l'efficacité d'un modèle en production dépend autant de son architecture que de la stack logicielle qui l'héberge. vLLM, avec ses innovations comme PagedAttention et le batching continu, est devenu un standard pour la production à grande échelle sur GPU.
Le blog de vLLM regorge d'annonces récentes, notamment un support Day-0 pour Flint (21 octobre 2026), l'introduction de vLLM TorchTPU (20 octobre 2026), et l'annonce de Humming, des kernels rapides et flexibles pour l'inférence quantifiée (19 octobre 2026). Ces développements continus montrent que l'écosystème autour de l'inférence locale est en pleine effervescence. Mais surtout, une annonce du 7 octobre 2026 sur le blog de vLLM mentionnait déjà un '5x Agentic Throughput Since Day 0' pour DeepSeek-V4.1-Flash sur vLLM. Cela confirme que la synergie entre DeepSeek et vLLM est au cœur de ces gains de performance. Nous avons déjà exploré cette synergie en profondeur dans nos articles comme Ollama, DeepSeek-V4.1-Flash et vLLM : Le Triptyque Qui Redéfinit l'Inférence Locale Agentique ou encore DeepSeek-V4.1-Flash et vLLM : Le Débit Agentique Multiplié Par Cinq Redéfinit l'Inférence Locale.
Cette intégration poussée avec vLLM nous permet d'exploiter pleinement le potentiel de DeepSeek-V4.1-Flash-1017 sur nos clusters GPU. Nous pouvons gérer des contextes plus longs, des requêtes concurrentes, et maintenir une latence faible, même avec des charges importantes. C'est essentiel pour nos clients qui déploient des agents conversationnels ou des systèmes d'automatisation avancée.
Les Implications pour l'IA Agentique en Entreprise
Ce bond en avant de DeepSeek-V4.1-Flash-1017 a des répercussions directes sur la conception et le déploiement de nos architectures multi-agents. Une meilleure performance en inférence locale signifie plusieurs choses pour l'entreprise :
- Réduction des coûts d'API : En exécutant les modèles en interne, nous réduisons drastiquement notre dépendance aux APIs cloud et les coûts associés. C'est un argument de poids pour nos clients PME qui cherchent à optimiser leur budget IA.
- Confidentialité et souveraineté des données : Les données sensibles restent sur l'infrastructure de l'entreprise. C'est un critère non négociable pour de nombreux secteurs, et cela répond aux exigences de conformité comme l'EU AI Act, même si le modèle n'est pas européen.
- Latence améliorée : L'élimination des allers-retours réseau se traduit par des temps de réponse plus rapides, cruciaux pour les applications en temps réel et les interactions utilisateur fluides.
- Flexibilité d'expérimentation : Avoir le modèle en local permet des itérations plus rapides, des ajustements plus fins et une intégration plus profonde dans les systèmes existants. Nous pouvons tester des architectures d'agents plus audacieuses, comme celles que nous explorons avec LangGraph ou CrewAI, sans nous soucier des frais d'API à chaque test.
Nous voyons des cas d'usage se multiplier : des agents de support client qui traitent des requêtes complexes en interne, des assistants de développeurs qui génèrent du code et des tests sans exposer la propriété intellectuelle, ou encore des systèmes d'analyse de documents qui opèrent en toute confidentialité. La capacité à exécuter ces tâches avec une grande efficacité en local déverrouille des scénarios qui étaient jusqu'à présent trop coûteux ou trop risqués avec des modèles cloud.
Au-delà de l'Hype : Les Réalités de l'Intégration
Soyons clairs, l'inférence locale n'est pas une baguette magique. Si DeepSeek-V4.1-Flash-1017 apporte des gains significatifs, le déploiement en production reste une affaire d'ingénierie. Il faut le matériel adéquat : des GPU avec suffisamment de VRAM. Si un Mac Studio avec 512 Go de RAM peut faire tourner Qwen 3.8 27B et Mistral Medium 3.5 128B confortablement, pour des modèles plus grands ou des charges concurrentes, on parle de serveurs dédiés avec des cartes NVIDIA de dernière génération.
La complexité de setup de vLLM, bien que récompensée par la performance, est supérieure à celle d'Ollama pour un usage simple. Il faut une expertise en MLOps, des compétences en optimisation des kernels, et une gestion attentive des versions de modèles et des dépendances logicielles. Chez Astoïk, c'est notre quotidien. Nous gérons ces réalités pour nos clients, en choisissant le bon équilibre entre performance, coût et maintenabilité. Un modèle comme DeepSeek-V4.1-Flash-1017 est un formidable outil, mais il demande une main experte pour être pleinement exploité. Il ne s'agit pas juste de faire un ollama pull et de s'attendre à des miracles pour des usages critiques.
Il y a aussi la question des cas limites. Pour des tâches de recherche très complexes, des raisonnements de très haut niveau ou des workflows agentiques qui doivent planifier sur des outils très variés et inconnus, les modèles cloud les plus puissants peuvent encore avoir l'avantage. C'est une question de jugement pour chaque workload. Notre rôle est de guider nos clients vers l'approche hybride la plus pertinente, en routant chaque tâche vers le modèle (local ou cloud) qui répond le mieux à ses exigences de qualité, latence, sécurité et coût.
La Vision Astoïk : Capitaliser sur l'Ouvert pour l'Entreprise
L'arrivée de DeepSeek-V4.1-Flash-1017 est une excellente nouvelle pour l'écosystème open-source et pour l'IA d'entreprise. Nous y voyons une confirmation de notre stratégie : investir massivement dans l'inférence locale et les modèles à poids ouverts pour offrir à nos clients une maîtrise inégalée de leur stack IA. C'est une démarche d'émancipation vis-à-vis des géants du cloud, qui permet une personnalisation et une sécurité sans précédent.
Nous continuons à tester activement ce modèle sur nos infrastructures, à le comparer avec des alternatives comme Mistral Large 4, et à explorer comment ses performances peuvent être maximisées avec des solutions comme vLLM pour des architectures multi-agents. Nous sommes convaincus que les prochaines années verront une démocratisation encore plus forte de l'IA performante en local, et nous serons là pour accompagner nos clients dans cette transition. Le potentiel est immense, et nous sommes prêts à le débloquer.
Cette vague d'innovation nous pousse à affiner nos architectures, à optimiser nos pipelines d'intégration et à former nos équipes aux dernières avancées. C'est un défi stimulant, mais c'est aussi ce qui fait notre force chez Astoïk : transformer ces avancées techniques brûlantes en solutions concrètes et performantes pour nos clients.
« La capacité à exécuter des modèles de pointe en local n'est plus une option, c'est une exigence stratégique pour les entreprises qui veulent innover avec l'IA tout en gardant le contrôle. »
- Lou Chardin, Head of Product et Architecte Technique chez Astoïk
Besoin d'avancer sur ce sujet ?
Discutons de vos enjeux spécifiques lors d'un audit informel.
Lou Chardin
Head of Product
Conçoit les architectures de données et les OS métiers IA d'Astoïk. Passionné par l'intégration pratique de l'IA générative.
Profil LinkedIn