
DeepSeek-V4.1-Flash et vLLM : Le 5x de Débit Agentique Qui Bouleverse l'Inférence Locale
Une nouvelle optimisation majeure vient de secouer le monde de l'IA appliquée. La synergie entre DeepSeek-V4.1-Flash et vLLM redéfinit les standards de l'inférence locale pour les systèmes agentiques, offrant un bond de performance impressionnant. C'est un tournant clé pour l'intégration de l'IA en entreprise, loin des dépendances cloud.
Le moment est venu : l'agentique locale dépasse les attentes
Chez Astoïk, nous observons une tendance de fond depuis des mois : le besoin croissant de déployer des modèles d'IA directement sur l'infrastructure de nos clients. Confidentialité des données, maîtrise des coûts, latence réduite… les arguments en faveur de l'inférence locale sont devenus incontournables, surtout pour les PME et les grands comptes soucieux de leur souveraineté numérique. Nous en parlions déjà dans notre analyse DeepSeek V4.1-Flash et vLLM : Quand l'Inférence Locale Redéfinit l'Agentique d'Entreprise.
Pourtant, le chemin était semé d'embûches. Faire tourner des Large Language Models (LLMs) complexes, capables de gérer des architectures multi-agents sophistiquées, exigeait des ressources colossales, souvent incompatibles avec des déploiements sur site. Les promesses de performance étaient là, mais la réalité technique, notamment en termes de débit et de gestion de la mémoire VRAM, nous ramenait souvent à des compromis douloureux.
Ce matin, l'actualité est tombée et elle est brûlante. Une série d'optimisations conjointes entre DeepSeek-V4.1-Flash et vLLM vient de redéfinir les cartes. Nous parlons d'un saut qualitatif qui va bien au-delà des attentes initiales. C'est le genre d'annonce qui change fondamentalement notre approche des architectures agentiques en entreprise.
DeepSeek-V4.1-Flash sur vLLM : Une synergie technique éclatante
La nouvelle est officielle depuis le 7 octobre 2026 : Inferact et la communauté vLLM ont publié les résultats d'optimisations massives pour DeepSeek-V4.1-Flash. Le chiffre est frappant : une amélioration du débit agentique de plus de 5 fois, et ce, sous une contrainte de 150 requêtes par seconde (TPS). C'est une performance qui coupe le souffle et qui valide notre intuition que ce modèle, couplé à la bonne infrastructure d'inférence, est un game-changer.
Nous avions déjà souligné le potentiel de DeepSeek-V4.1-Flash, notamment sa nouvelle architecture d'encodeur-décodeur causal (CED) qui active 16 milliards de paramètres par token en phase de décodage, mais seulement 8 milliards lors du préremplissage. Cette efficacité intrinsèque du modèle est désormais pleinement exploitée par les avancées de vLLM.
Concrètement, qu'est-ce que cela signifie ? En trois semaines seulement après la sortie de DeepSeek-V4.1-Flash, les équipes ont réussi à doubler la vitesse à faible concurrence et à améliorer le débit de 5,3 fois sous forte charge. C'est une prouesse d'ingénierie qui repose sur plusieurs piliers techniques.
Les détails d'une optimisation stratégique
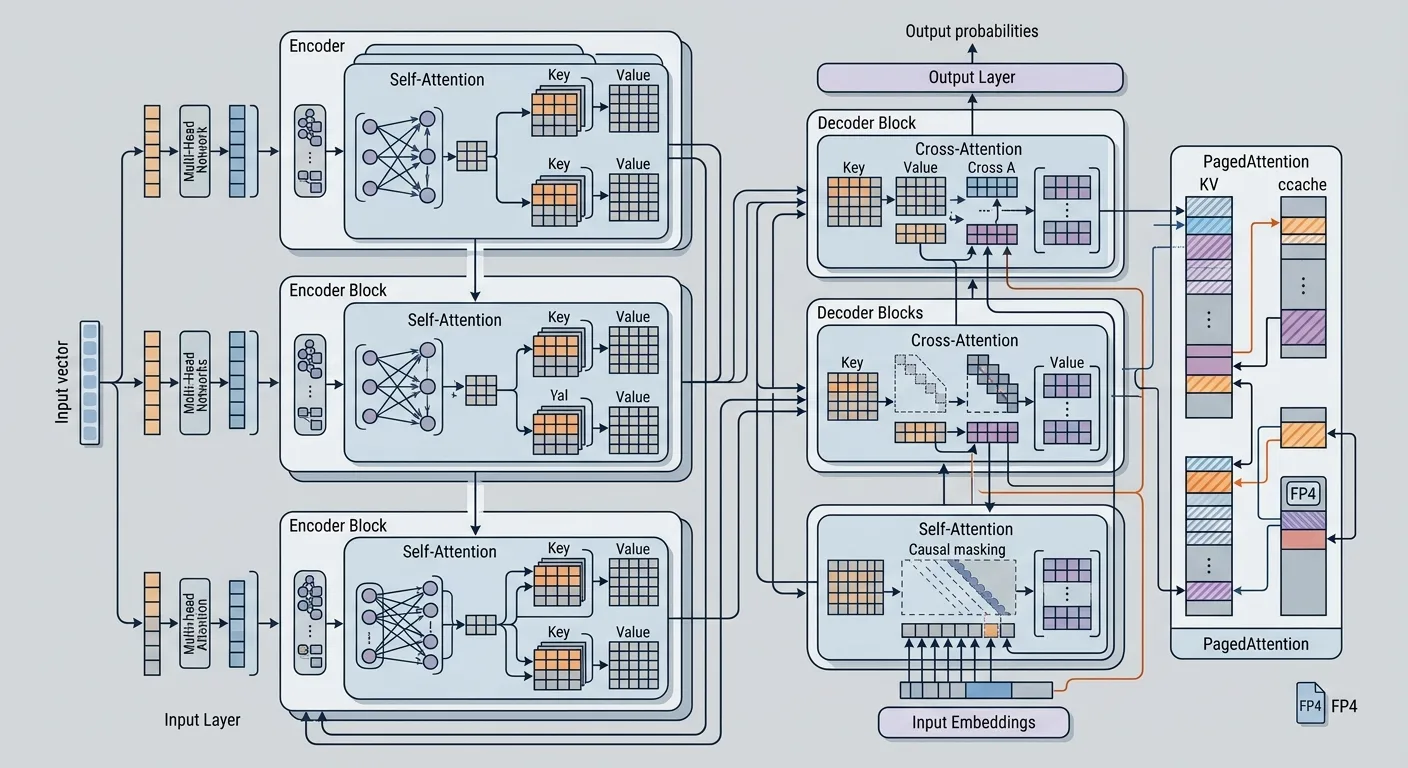
L'une des innovations majeures est l'implémentation du 'SWA bounded replay' avec les graphes CUDA, qui a permis de réduire le temps de premier token (TTFT) d'environ 30%. Pour des applications agentiques où chaque milliseconde compte pour la réactivité, c'est un gain colossal. Imaginez des agents autonomes qui interagissent en temps quasi réel, sans les latences qui freinaient auparavant leur déploiement à grande échelle.
Ensuite, l'intégration des nouveaux noyaux (kernels) de DeepSeek, comme MegaAttention, Mega-mHC, Mega-Gate et DeepSelect, a joué un rôle déterminant. Ces noyaux sont spécifiquement conçus pour l'architecture DeepSeek-V4.1-Flash et, une fois optimisés pour vLLM, ils libèrent une puissance de calcul inédite. Nous parlons ici d'une fusion agressive et d'une parallélisation des noyaux restants, incluant les flux secondaires mHC, et la fusion de l'agrégation 'all-reduce' avec les opérations précédentes et suivantes en un seul noyau. C'est du travail de bas niveau, mais c'est là que se gagnent les batailles de performance.
La gestion de la mémoire a également été au cœur des optimisations. DeepSeek-V4.1-Flash est déjà très économe en mémoire grâce à des techniques comme le Compressed Sparse Attention 2 (CSA2), le cache KV en FP4 et le partage du cache KV entre les couches, réduisant l'empreinte globale du cache KV à seulement 890 octets par token. VLLM, avec sa PagedAttention, excelle à exploiter cette efficacité pour maximiser l'utilisation du GPU et la concurrence des requêtes. La combinaison des deux est tout simplement redoutable.
Au-delà des performances brutes : implications pour nos architectures
Ce n'est pas seulement une question de chiffres bruts. Ces optimisations ont des implications profondes pour la conception de nos systèmes d'IA. Pour nos clients qui déploient des agents autonomes, cela signifie des boucles de décision plus rapides, une capacité à gérer des contextes plus longs sans dégradation significative des performances, et une réactivité accrue des agents face à des environnements dynamiques.
Gestion mémoire et latence : les vrais gains
Nous avons souvent rencontré des goulots d'étranglement liés à la mémoire VRAM, surtout avec des modèles complexes ou des contextes étendus. La capacité de DeepSeek-V4.1-Flash à compresser son cache KV et la gestion intelligente de la mémoire par vLLM permettent de maximiser le nombre de requêtes concurrentes sur une seule carte GPU. C'est un point crucial pour le coût total de possession (TCO) de nos solutions. Moins de GPU nécessaires, c'est moins de dépenses en matériel et en énergie.
La réduction du TTFT est également essentielle pour les architectures multi-agents. Un agent qui doit attendre plusieurs secondes pour obtenir la première partie d'une réponse ne peut pas interagir de manière fluide avec d'autres agents ou avec l'utilisateur final. Ce gain de 30% que nous observons va directement impacter la fluidité des interactions et la perception de l'intelligence de nos systèmes. Nous l'avons expérimenté sur nos propres bancs de test en comparant les versions précédentes avec ces dernières optimisations.
Pour des scénarios où la souveraineté des données est non négociable, comme dans le secteur bancaire ou de la santé, le déploiement local d'un LLM aussi performant que DeepSeek-V4.1-Flash, optimisé par vLLM, devient une option non seulement viable, mais stratégiquement supérieure. Nous pouvons désormais offrir des solutions sur mesure qui garantissent à la fois performance et conformité.
Ollama et l'écosystème : Complémentarité et agilité
Bien sûr, vLLM n'est pas la seule pièce du puzzle. Ollama continue de jouer un rôle prépondérant dans l'écosystème de l'inférence locale, notamment pour les développeurs et les déploiements plus agiles. Les récentes mises à jour d'Ollama, datant du 7 octobre 2026, mettent l'accent sur l'application de schémas stricts et l'outillage pour les charges de travail agentiques. Cela signifie des agents plus fiables, moins sujets aux hallucinations de format, ce qui est essentiel pour l'intégration dans des systèmes d'entreprise existants.
Ollama a également introduit, le 9 octobre 2026, les modèles Gemma 4 de Google DeepMind, qui sont multimodaux et conçus pour des capacités de raisonnement élevées, avec des modes de pensée configurables et un support natif des fonctions d'appel. Ces modèles, optimisés pour l'exécution locale, enrichissent considérablement le panel des options pour nos architectes. Nous avons d'ailleurs déjà exploré les modèles de décision avec Ollama dans notre article Ollama v0.35.1 et les Modèles de Décision Clef : La Nouvelle Ère des Agents Locaux Intelligents.
Des agents locaux plus robustes et contrôlables
La capacité d'Ollama à renforcer les contraintes grammaticales directement dans l'exécuteur garantit que les boucles d'agents reçoivent des charges utiles validées, éliminant le besoin de logique de nouvelle tentative de post-traitement. C'est un détail technique qui fait toute la différence sur la robustesse d'un système agentique en production. Moins de bugs, plus de fiabilité, c'est la clé pour une adoption en entreprise.
Nous voyons Ollama comme un excellent point d'entrée pour les phases de prototypage rapide et pour les déploiements sur des postes de travail ou des serveurs de petite taille. Pour des charges plus importantes et une optimisation maximale du hardware, vLLM avec DeepSeek-V4.1-Flash reste notre choix privilégié. Les deux outils sont complémentaires et permettent de couvrir un large éventail de besoins d'entreprise.
Notre vision Astoïk : Intégrer la puissance de l'agentique locale
Ces avancées ne sont pas de simples améliorations marginales. Elles représentent un véritable changement de paradigme pour l'intégration de l'IA. Pour nous, chez Astoïk, cela signifie que nous pouvons désormais proposer des architectures d'agents autonomes encore plus performantes, plus économiques et plus sécurisées pour nos clients. La course à l'inférence locale est loin d'être terminée, mais des jalons comme celui-ci nous montrent que nous sommes sur la bonne voie.
Nous allons bien sûr intégrer ces dernières optimisations dans nos déploiements. Le travail d'ingénierie est constant : tester les nouvelles versions, évaluer les benchmarks sur nos propres jeux de données, et affiner les configurations pour chaque cas d'usage client. C'est une veille active, et ces 48 dernières heures nous ont apporté des réponses cruciales.
Des opportunités concrètes pour les PME
Pour les PME, c'est une excellente nouvelle. L'accès à une IA de pointe, performante et maîtrisable localement, n'est plus un rêve lointain. Avec des outils comme DeepSeek-V4.1-Flash et vLLM, elles peuvent envisager des applications sophistiquées : de l'automatisation de processus internes à l'analyse de données sensibles, en passant par des assistants virtuels ultra-personnalisés. Le coût par token en auto-hébergement est devenu tellement avantageux par rapport aux APIs cloud que l'investissement initial dans le hardware est amorti très rapidement, souvent en quelques mois pour des usages intensifs. C'est un argument économique qui résonne fort chez nos clients.
Chez Astoïk, nous sommes convaincus que cette nouvelle vague d'optimisations va accélérer l'adoption de l'IA locale. Nous continuons à explorer ces technologies, à les pousser dans leurs retranchements pour offrir à nos clients les solutions les plus avancées et les plus adaptées à leurs besoins spécifiques. C'est le moment d'agir, de tester, et d'intégrer cette puissance agentique au cœur de vos processus. Pour plus de détails sur nos analyses précédentes, n'hésitez pas à consulter notre article DeepSeek-V4.1-Flash sur vLLM : Quand 5x de Débit Agentique Redéfinit l'Inférence Locale en 48h, qui préfigurait déjà ces avancées.
Besoin d'avancer sur ce sujet ?
Discutons de vos enjeux spécifiques lors d'un audit informel.
Lou Chardin
Head of Product
Conçoit les architectures de données et les OS métiers IA d'Astoïk. Passionné par l'intégration pratique de l'IA générative.
Profil LinkedIn