
DeepSeek-V4.1-Flash et vLLM sur Vera Rubin NVL72 : Le Débit Agentique Multiplié Par Huit Qui Change Tout
Une nouvelle est tombée ces dernières 48 heures et elle va redéfinir nos stratégies d'inférence locale : le support de vLLM pour la plateforme NVIDIA Vera Rubin NVL72. Combiné aux performances déjà impressionnantes de DeepSeek-V4.1-Flash, nous parlons d'un bond de géant pour le débit agentique, avec des implications directes sur les coûts et la réactivité de nos systèmes IA en entreprise. C'est un tournant majeur pour les déploiements sur site.
L'inférence locale : un impératif stratégique pour l'IA d'entreprise
Chez Astoïk, nous le répétons depuis des mois à nos clients : l'avenir des systèmes d'IA en entreprise ne se limite pas aux APIs cloud. La maîtrise de l'inférence locale, c'est la clé de la souveraineté des données, d'une latence minimale et, surtout, d'une optimisation drastique des coûts. Les allers-retours incessants vers des serveurs distants, avec leurs charges par token et leurs risques de fuite d'informations sensibles, sont devenus un frein majeur à l'adoption de l'IA à grande échelle. On ne peut plus se permettre d'ignorer ces aspects.
Pendant longtemps, la complexité de la gestion des modèles open source en local, la gourmandise en VRAM et les performances parfois décevantes freinaient nos ambitions. Les infrastructures n'étaient pas toujours prêtes. Mais la donne change, et vite. Nous sommes témoins d'une accélération sans précédent des innovations sur ce front, avec des modèles et des frameworks qui repoussent constamment les limites du possible sur site.
NVIDIA Vera Rubin NVL72 et vLLM : un bond de géant pour le débit agentique
L'actualité brûlante de ces dernières 48 heures, c'est l'annonce du support officiel de vLLM pour la plateforme NVIDIA Vera Rubin NVL72. Ce n'est pas une simple mise à jour logicielle, c'est une véritable révolution pour l'inférence locale à grande échelle, spécialement pour les charges de travail d'IA agentique. Les chiffres parlent d'eux-mêmes : jusqu'à 7,8 fois plus de débit par GPU par rapport à la génération précédente (GB200 NVL72) sur le benchmark AgentX. C'est un gain colossal. Pour nous, qui architecturons des systèmes multi-agents complexes pour nos clients, cela signifie une capacité à traiter un volume d'interactions bien plus important avec la même infrastructure, ou à réduire drastiquement les besoins en hardware pour des charges équivalentes. L'efficacité par watt est stupéfiante.
La plateforme Vera Rubin NVL72 est conçue spécifiquement pour ces charges de travail d'IA agentique. Elle intègre une bande passante mémoire HBM4 améliorée, offrant jusqu'à 2,4 fois plus de bande passante que le GB200 NVL72. Elle propose également des optimisations profondes pour les opérations clés des LLMs, comme le GEMM (General Matrix Multiply), le MoE (Mixture of Experts) et les mécanismes d'attention, qui sont au cœur de la performance des modèles modernes. vLLM tire pleinement parti de ces avancées avec des noyaux FlashInfer optimisés spécifiquement pour Rubin et une gestion des MoE sensible à la localité. Cela permet aux Streaming Multiprocessors (SM) de lire les poids uniquement depuis la mémoire la plus proche, réduisant ainsi les goulots d'étranglement et maximisant l'efficacité du calcul.
C'est une validation forte de notre pari sur l'optimisation hardware-software. Le débit agentique, cette métrique essentielle pour la réactivité de nos agents autonomes, vient de franchir un cap que nous n'espérions pas si tôt. L'impact sur les performances de nos déploiements est direct et mesurable, ouvrant la voie à des interactions plus fluides et des décisions plus rapides pour les utilisateurs finaux.

DeepSeek-V4.1-Flash : le champion open source de l'agentique locale
Cette avancée de vLLM arrive à point nommé, car DeepSeek-V4.1-Flash, un modèle open-weight sous licence MIT, s'est déjà imposé comme un acteur incontournable pour l'inférence locale. Lancé le 10 septembre 2026, ce modèle de 552 milliards de paramètres totaux (avec seulement 8 milliards actifs en entrée et 16 milliards en sortie) a démontré des capacités de raisonnement et de codage qui surpassent même certains modèles propriétaires phares. Sur des benchmarks comme Terminal-Bench 2.1, il affiche un score de 90.6, se positionnant devant Claude Opus 5 et GPT-5.6 Sol. C'est une prouesse technique qui redéfinit ce qu'on peut attendre d'un LLM déployé sur site, en termes de puissance et de précision.
DeepSeek a d'ailleurs confirmé la supériorité de V4.1-Flash en annonçant la redirection du trafic de son modèle V4-Pro vers cette nouvelle version, avec une réduction des coûts de 70% pour l'inférence en sortie. C'est une décision forte qui témoigne de l'efficacité de sa nouvelle architecture Causal Encoder-Decoder et de ses techniques de compression avancées du cache KV, réduisant la consommation de mémoire de manière drastique (jusqu'à 1/4 pour la HBM et 1/8 pour le stockage SSD). Ces gains ne sont pas anecdotiques ; ils sont concrets et se traduisent directement par des optimisations significatives de nos budgets d'infrastructure et une meilleure gestion des ressources matérielles.
Nous l'avions déjà souligné dans nos analyses, DeepSeek-V4.1-Flash avec vLLM avait déjà permis de multiplier par 5 le débit agentique dans les trois semaines suivant sa sortie, grâce à des optimisations comme le SWA bounded replay, les graphes CUDA, les nouveaux noyaux DeepSeek et les fusions de noyaux vLLM. L'ajout du support Vera Rubin NVL72 vient amplifier ces gains de manière exponentielle, propulsant l'inférence locale à un niveau inédit de performance. C'est le genre de synergie qui nous passionne chez Astoïk.
Ollama et LangChain : des écosystèmes qui maturent pour l'agentique
Au-delà des performances brutes des modèles et des moteurs d'inférence, l'écosystème autour de l'inférence locale ne cesse de se consolider, rendant ces déploiements plus accessibles et robustes. Ollama, par exemple, a récemment introduit des fonctionnalités de validation de schéma et de tooling qui sont cruciales pour la fiabilité et la prévisibilité de nos agents. L'application des contraintes grammaticales sans contexte directement au niveau du runtime garantit que les boucles d'agents reçoivent des payloads validés, éliminant ainsi des classes entières de logiques de retry post-traitement. C'est un gain de temps considérable pour nos développeurs et une amélioration de la robustesse inestimable pour les systèmes en production.
De son côté, LangChain a également annoncé en octobre une intégration avec vLLM, simplifiant le déploiement local des LLMs et réduisant l'utilisation de la mémoire. Ces outils sont devenus des piliers de notre architecture pour concevoir et orchestrer des agents autonomes. On voit clairement que l'industrie converge vers des solutions plus matures et plus efficientes, ce qui nous conforte dans nos choix technologiques. Nous avons d'ailleurs exploré les modèles de décision clef avec Ollama v0.35.1, qui ouvrent de nouvelles perspectives pour des agents locaux capables de raisonnement plus fin.
Implications concrètes pour les entreprises : coûts, latence et souveraineté
Ces avancées ne sont pas que des prouesses techniques ; elles ont des répercussions directes et profondes sur la stratégie IA de nos clients, notamment les PME et grands groupes qui cherchent à industrialiser leurs usages de l'IA. Nous parlons de :
- Réduction drastique des coûts d'inférence : Avec des modèles comme DeepSeek-V4.1-Flash et les optimisations de vLLM sur du hardware de pointe, le coût par token en local devient imbattable, souvent une fraction de ce que coûtent les APIs cloud. C'est essentiel pour des applications à fort volume d'utilisation ou des déploiements massifs d'agents.
- Latence ultra-faible pour les agents : Un agent qui doit prendre des décisions en temps réel, interagir avec un utilisateur ou piloter des systèmes critiques ne peut pas se permettre des latences réseau. L'inférence locale avec un débit multiplié permet des interactions fluides et instantanées, créant une expérience utilisateur sans précédent.
- Souveraineté et sécurité des données renforcées : C'est un point non négociable pour beaucoup de nos clients. Les données sensibles ne quittent plus l'infrastructure de l'entreprise, respectant les réglementations strictes comme l'EU AI Act et les politiques internes de confidentialité. C'est un argument de vente majeur pour les secteurs réglementés comme la finance, la santé ou la défense.
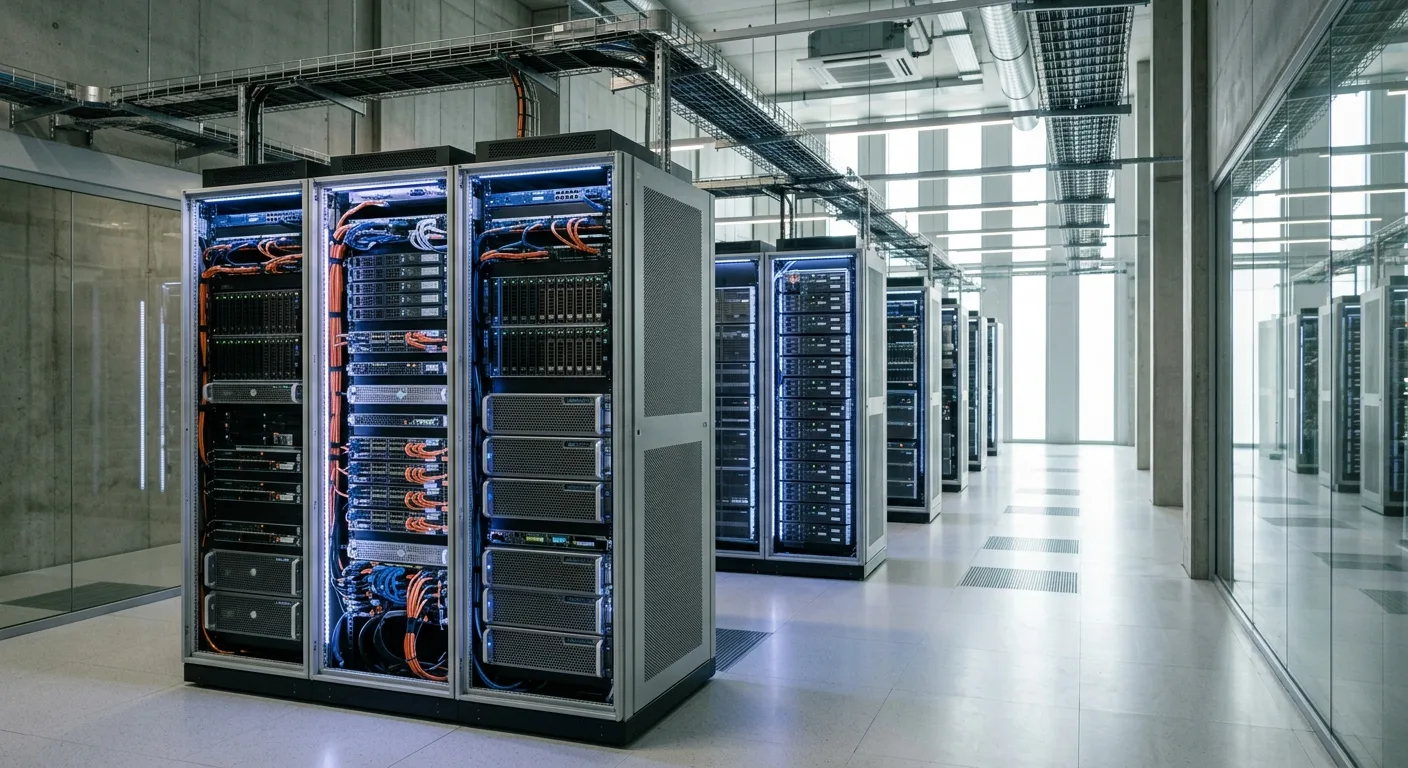
Sur nos déploiements, nous constatons que ces gains permettent d'envisager des architectures multi-agents beaucoup plus ambitieuses. Fini les compromis entre performance et coût, ou la nécessité de sacrifier la confidentialité pour la puissance de calcul. Nous pouvons désormais concevoir des systèmes où chaque agent dispose de sa propre logique de raisonnement, interagit avec des bases de données internes (PostgreSQL, Firestore, Pinecone, Redis) et exécute des tâches complexes, sans exploser les budgets. Cela ouvre la voie à des assistants virtuels plus intelligents, des systèmes d'automatisation plus robustes et des outils d'aide à la décision plus performants et plus sûrs.
Les défis à relever : au-delà de l'enthousiasme initial
Bien sûr, il serait naïf de penser que tout est parfait et sans effort. L'intégration de ces technologies de pointe demande toujours une expertise pointue. Il faut dimensionner correctement l'infrastructure – la Vera Rubin NVL72, c'est du hardware de pointe qui a un coût et une complexité de déploiement – maîtriser les subtilités de configuration de vLLM, et optimiser les modèles pour des cas d'usage spécifiques. La VRAM reste un facteur limitant pour les très grands modèles, surtout pour des contextes longs et une forte concurrence, même avec les avancées en compression du cache KV.
Nous suivons aussi de près l'évolution de modèles comme DeepSeek V5, qui est un peu notre Arlésienne de l'open source (DeepSeek V5 : Le Modèle Qui Redéfinit l'Inférence Locale et l'Agentique d'Entreprise, ou l'Arlésienne de l'Open Source ?). Pour l'instant, V4.1-Flash remplit parfaitement son rôle et surpasse les attentes, mais la course à la performance est sans fin. Nous devons rester agiles et prêts à intégrer les prochaines innovations, à tester les nouveaux benchmarks et à évaluer leur pertinence pour nos besoins métiers.
Les benchmarks, même s'ils sont impressionnants sur le papier, ne reflètent pas toujours la complexité des scénarios réels en entreprise. Nous passons beaucoup de temps à valider ces performances sur nos propres jeux de données, avec les contraintes spécifiques de nos clients (intégration d'APIs REST existantes, gestion des webhooks, etc.). C'est là que notre expérience terrain fait toute la différence, en transformant les promesses techniques en solutions opérationnelles et à forte valeur ajoutée.
Perspectives : l'ère des agents autonomes réellement performants
Cette convergence de performances matérielles et logicielles ouvre une nouvelle ère pour les agents autonomes en entreprise. La capacité à exécuter des LLMs complexes en local avec une telle efficacité change radicalement la donne. Nous pouvons désormais envisager des architectures multi-agents plus sophistiquées, avec des agents spécialisés qui interagissent en temps réel, sans contraintes de latence ou de coût prohibitif. C'est une véritable démocratisation de la puissance de calcul IA pour les déploiements sur site.
Pour Astoïk, cela signifie une opportunité sans précédent de développer des solutions IA encore plus puissantes et personnalisées pour nos clients. Nous allons continuer à explorer les limites de ces technologies, à optimiser nos déploiements et à partager nos retours d'expérience via notre blog et nos projets open source. La veille technologique n'a jamais été aussi passionnante, et les prochaines semaines promettent d'être riches en découvertes, consolidant notre positionnement d'agence experte en IA appliquée.
Besoin d'avancer sur ce sujet ?
Discutons de vos enjeux spécifiques lors d'un audit informel.
Lou Chardin
Head of Product
Conçoit les architectures de données et les OS métiers IA d'Astoïk. Passionné par l'intégration pratique de l'IA générative.
Profil LinkedIn