
Ollama v0.35.0 et les Modèles de Décision : Une Révolution Discrète pour l'Agentique Locale
La dernière mise à jour d'Ollama, la v0.35.0, introduit un concept puissant : les modèles de décision. Cette nouveauté, couplée aux avancées multimodales de modèles comme DeepSeek-V4.1-Flash, transforme en profondeur la manière dont nous concevons et déployons des agents autonomes en inférence locale. C'est une étape cruciale pour l'orchestration de workflows complexes sur nos machines.
Le rythme effréné de l'innovation en intelligence artificielle ne ralentit jamais. Ces dernières 24 à 48 heures, une mise à jour d'Ollama, la version 0.35.0, a discrètement posé les jalons d'une nouvelle ère pour l'inférence locale. Ce n'est pas qu'une simple itération. L'introduction des modèles de décision marque un tournant, promettant de redéfinir la manière dont nous abordons les architectures d'agents autonomes sur nos propres infrastructures. Nous parlons ici de capacité à faire des choix pondérés, localement, sans dépendre systématiquement d'APIs cloud coûteuses et gourmandes en latence.
Ollama v0.35.0 : Quand la Décision Devient Locale
La grande nouveauté de cette version 0.35.0, déployée il y a seulement quelques heures, réside dans le support des « modèles de décision » via la nouvelle API /v1/systemone. Ce n'est pas un concept anodin. Jusqu'à présent, les LLMs excellaient à générer du texte, à répondre à des questions, à synthétiser des informations. Mais prendre des décisions structurées, avec des probabilités et des scores, restait souvent le domaine de logiques externes ou de chaînes de prompts complexes. Ollama change la donne en intégrant nativement cette capacité.
Concrètement, des modèles comme Nimble de Bespoke Labs ou Tev1 de Together AI peuvent désormais être utilisés pour des tâches de classification, de routage de tickets ou de modération de contenu. Au lieu d'une simple sortie textuelle, on obtient des choix, des probabilités associées à ces choix, et des scores de confiance. Imaginez l'impact sur des systèmes d'agents où chaque étape du workflow nécessite une validation ou une orientation précise. Nous voyons déjà des applications directes pour nos clients PME, notamment dans l'automatisation de la qualification de leads ou la priorisation de demandes de support technique. C'est un gain de temps et une réduction d'erreurs considérable.
L'API prend en charge trois types de questions : choice pour sélectionner une option parmi plusieurs, noul pour évaluer la probabilité qu'une condition soit vraie, et score pour attribuer un score sur un ensemble de critères ordonnés. C'est une granularité de contrôle que nous recherchions depuis longtemps pour nos architectures d'agents. Cela permet de passer d'une logique « si-alors » rigide à une logique probabiliste beaucoup plus souple et adaptative, directement au cœur de l'inférence locale. La flexibilité est immense, les possibilités d'intégration avec des outils existants, comme les systèmes de gestion de tickets ou les CRM, sont démultipliées.
La Convergence Multimodale avec DeepSeek-V4.1-Flash
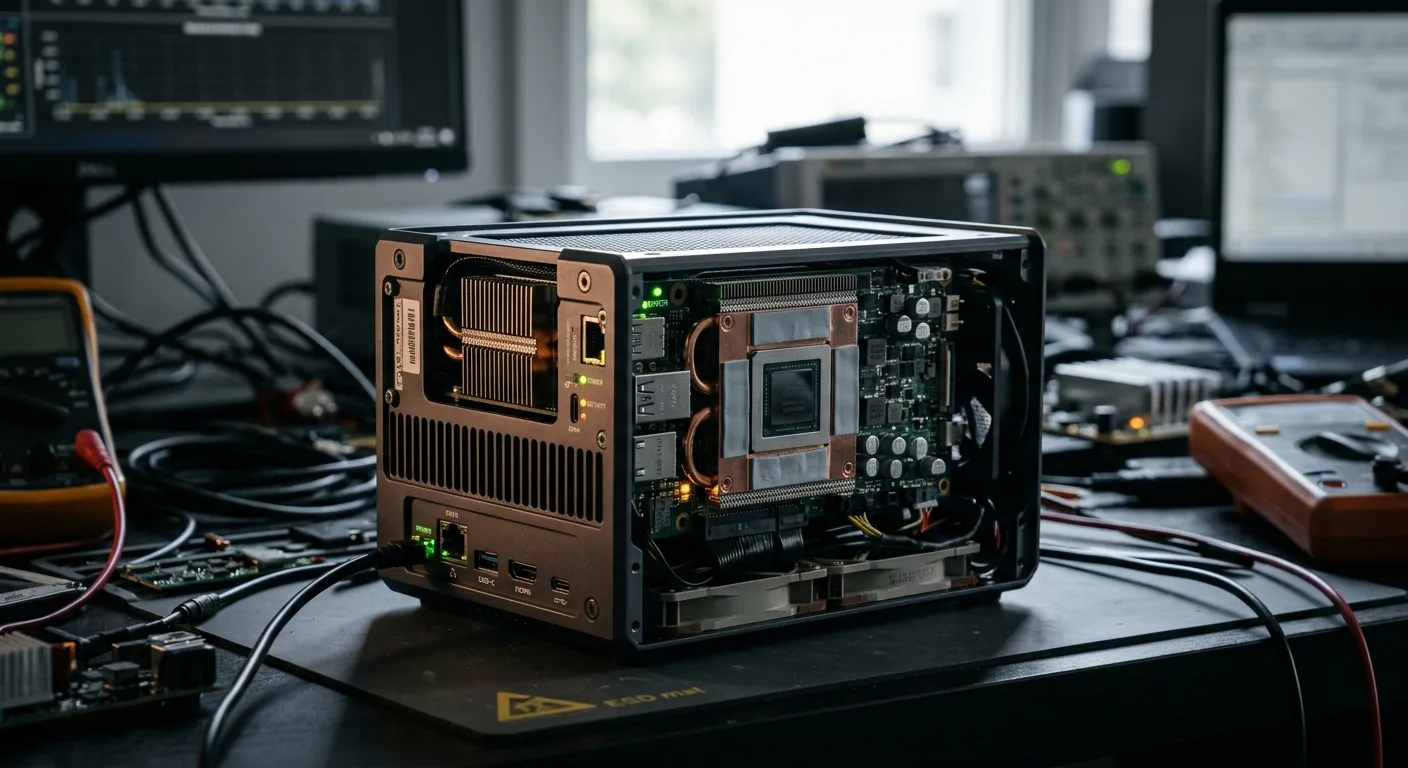
Cette avancée d'Ollama ne vient pas seule. Elle s'inscrit dans un mouvement plus large d'amélioration continue des modèles open source et de l'inférence locale. Le récent déploiement de DeepSeek-V4.1-Flash, le 10 septembre 2026, est un exemple frappant. Ce modèle, bien que présenté comme le plus petit d'une nouvelle famille architecturale, apporte une compréhension visuelle multimodale native. Cela signifie que nos agents peuvent désormais non seulement prendre des décisions textuelles complexes, mais aussi intégrer des informations visuelles pour affiner leur raisonnement. C'est un pas de géant pour des applications nécessitant l'analyse de documents, de schémas ou d'images.
Chez Astoïk, nous avons beaucoup exploré la synergie entre des outils comme Ollama et des modèles performants. L'article Ollama 0.34.4 et DeepSeek-V4.1-Flash : L'Inférence Locale Multimodale Prend une Nouvelle Dimension pour Nos Agents IA détaillait déjà comment ces capacités multimodales transforment nos agents. Avec les modèles de décision d'Ollama, nous pouvons imaginer des agents qui analysent une capture d'écran d'une application (via DeepSeek-V4.1-Flash), identifient un problème, puis utilisent un modèle de décision pour classer la gravité ou suggérer une action corrective, le tout en local. C'est une boucle de feedback beaucoup plus riche et autonome.
Les benchmarks de DeepSeek-V4.1-Flash sont impressionnants sur des tâches comme GPQA Diamond, Terminal-Bench 2.1, DeepSWE v1.1 et CyberGym. Cela confirme que la qualité des modèles open source rivalise sérieusement avec les solutions propriétaires, surtout quand on les couple à des moteurs d'inférence optimisés comme vLLM ou Ollama. La réduction des prix de l'API DeepSeek pour V4.1-Flash est aussi un signe clair de la pression concurrentielle et de la démocratisation de ces technologies.
Impact sur l'Orchestration Agentique et les Architectures Multi-Agents
L'arrivée des modèles de décision dans Ollama simplifie grandement l'orchestration. Avant, pour qu'un agent prenne une décision non triviale, il fallait souvent passer par un LLM généraliste, puis parser sa réponse, et enfin appliquer une logique externe pour la transformer en une action concrète. C'était un processus fragile, coûteux en tokens et en latence. Désormais, un agent peut directement interroger un modèle de décision optimisé pour un cas d'usage spécifique, recevant une sortie structurée et exploitable immédiatement. Cela fluidifie les architectures multi-agents comme celles que nous construisons avec CrewAI ou LangGraph.
Pensez aux agents autonomes qui gèrent des pipelines de données ou des processus métiers complexes. Un agent pourrait, après avoir collecté des informations (potentiellement multimodales grâce à des modèles comme DeepSeek-V4.1-Flash), demander à un modèle de décision d'évaluer la meilleure prochaine étape parmi un ensemble prédéfini d'actions. L'article DeepSeek-V4.1-Flash : L'Open Source Redéfinit l'Inférence Locale et L'Agentique – Le Vrai V5 Déguisé ? soulignait déjà l'importance de ces avancées pour l'agentique. Maintenant, avec Ollama, nous avons un outil encore plus précis pour la 'colle' qui unit ces agents.
Nous observons une tendance claire vers des architectures d'agents plus modulaires et spécialisées. Plutôt qu'un seul LLM "à tout faire", nous utilisons un orchestrateur qui délègue des tâches spécifiques à des modèles plus petits et plus performants pour ces tâches. Les modèles de décision d'Ollama s'intègrent parfaitement dans cette philosophie. Ils peuvent servir de "routeurs intelligents" ou de "valideurs d'étapes" au sein d'un workflow agentique, réduisant ainsi la charge des LLMs principaux et optimisant les coûts d'inférence.
Performance, Coûts et Réalités de Déploiement en Production
Le nerf de la guerre en production, c'est toujours la performance et le coût. Les modèles de décision d'Ollama, par leur nature spécialisée, sont généralement plus petits et donc plus rapides à inférer. Cela a un impact direct sur la latence de nos agents. Pour les déploiements sur Apple Silicon, Ollama 0.35.0 apporte aussi des améliorations significatives en termes de gestion de la mémoire MLX et une accélération du traitement des prompts Qwen 3.8. C'est crucial pour les développeurs qui travaillent sur des Mac Studio ou des MacBook Pro, car cela ouvre la porte à des capacités d'inférence locale encore plus robustes.
Le coût des tokens est une préoccupation constante. En déchargeant les tâches de décision sur des modèles locaux et spécialisés, nous réduisons le nombre de requêtes aux APIs cloud pour les LLMs généralistes. Cela se traduit par des économies substantielles, surtout pour des volumes importants d'opérations. Sur nos déploiements, nous constatons que la capacité à exécuter des modèles comme DeepSeek-V4.1-Flash en local avec Ollama, et maintenant à prendre des décisions structurées localement, offre une maîtrise des coûts et une confidentialité des données inégalées. C'est un argument majeur pour nos clients évoluant dans des secteurs réglementés.
Cependant, il ne faut pas idéaliser. Le déploiement d'architectures d'agents complexes avec des modèles locaux demande une expertise technique solide. La gestion de la VRAM, l'optimisation des conteneurs (Docker, Kubernetes), et la surveillance des performances sont des défis réels. L'article Qwen3.8-Omni-Flash et Ollama : La Synergie Qui Redéfinit l'Agentique Locale montrait déjà l'importance de cette optimisation. Avec les modèles de décision, la complexité se déplace un peu : moins de 'prompt engineering' pour des décisions, plus de 'model orchestration' pour choisir le bon modèle de décision au bon moment.
Astoïk et la Vision de l'Agentique Locale
Chez Astoïk, nous sommes convaincus que l'avenir de l'IA appliquée en entreprise passe par une hybridation intelligente entre les capacités cloud et l'inférence locale. Les annonces récentes, notamment la v0.35.0 d'Ollama et les avancées de DeepSeek, renforcent cette conviction. Nous voyons l'émergence d'architectures d'agents où des modèles spécialisés, légers et efficaces, gèrent des micro-tâches, tandis que les grands modèles cloud sont réservés aux problèmes nécessitant une intelligence générale de pointe.
Notre expérience terrain, notamment avec des solutions comme Google Workspace et Gemini 3.8 Live pour l'orchestration agentique, nous montre que les entreprises cherchent à la fois puissance et contrôle. Des articles comme Google Workspace et Gemini 3.8 Live : L'Ère de l'Orchestration Agentique Redéfinit nos Workflows détaillent comment nous intégrons ces systèmes. Mais l'approche locale n'est pas en reste. Elle offre des avantages indéniables en termes de souveraineté des données, de personnalisation extrême et de réduction des coûts opérationnels sur le long terme. C'est une stratégie complémentaire, pas exclusive.
L'évolution d'Ollama vers les modèles de décision est une réponse directe aux besoins que nous identifions chez nos clients : des systèmes d'IA plus autonomes, plus fiables et plus intégrés à leurs environnements existants. Nous continuerons à pousser les limites de l'inférence locale et de l'agentique pour offrir des solutions concrètes et performantes. La prochaine étape sera d'explorer comment ces modèles de décision peuvent être entraînés sur des données spécifiques à chaque entreprise pour des prises de décision encore plus pertinentes, tout en gardant une empreinte matérielle maîtrisée.
Besoin d'avancer sur ce sujet ?
Discutons de vos enjeux spécifiques lors d'un audit informel.
Lou Chardin
Head of Product
Conçoit les architectures de données et les OS métiers IA d'Astoïk. Passionné par l'intégration pratique de l'IA générative.
Profil LinkedIn