
Qwen 4 : Alibaba Redéfinit l'Inférence Locale et les Architectures d'Agents, Nos Premiers Retours
Le récent aperçu de la série Qwen 4 par Alibaba marque un tournant majeur pour l'inférence locale et les systèmes d'agents. Nous avons analysé les implications de cette nouvelle architecture et les optimisations récentes d'Ollama et vLLM qui boostent déjà les performances des modèles Qwen sur nos infrastructures. C'est une avancée concrète qui change la donne pour nos déploiements en entreprise.
L'écosystème de l'IA ne dort jamais. Chaque semaine apporte son lot d'annonces, mais certaines résonnent plus fort que d'autres sur nos bancs de test. Cette fois, c'est Alibaba qui capte notre attention avec la révélation de sa série Qwen 4 lors de la conférence Apsara. Ce n'est pas qu'une simple mise à jour; c'est une refonte architecturale qui promet de bouleverser notre approche de l'inférence locale et, par extension, la conception de nos systèmes d'agents autonomes. Nous parlons ici de modèles comme Qwen 4 Max, Qwen 4 Flash, Qwen 4 Plus et Qwen 4 27B, dont les détails commencent à filtrer et qui s'annoncent comme des concurrents sérieux dans le paysage open source.
Chez Astoïk, nous suivons les modèles Qwen depuis leurs débuts. Leur performance sur les tâches multilingues et leur efficacité en inférence locale ont toujours été des points forts pour nos clients. L'arrivée de cette nouvelle génération, même en pré-annonce, est un signal fort. Cela nous pousse à anticiper les évolutions de nos infrastructures pour tirer parti de ces avancées, surtout quand on voit les progrès déjà réalisés sur les versions précédentes avec des outils comme Ollama et vLLM.
Qwen 4 : Une Nouvelle Architecture au Service de l'Agentique
Ce qui frappe avec la série Qwen 4, c'est l'ambition derrière la « nouvelle génération d'architecture » mentionnée par Liu Da Yiheng d'Alibaba. Sans les détails techniques précis des modèles finaux, nous pouvons déjà spéculer sur l'orientation. L'objectif est clair : des modèles plus performants, plus efficaces, et surtout, plus aptes à gérer des workflows complexes d'agents. C'est exactement ce que nous cherchons pour nos déploiements en entreprise. Les attentes sont fortes pour voir comment cette architecture va se traduire en termes de gestion contextuelle, de capacité multimodale native et de robustesse face aux tâches agentiques qui requièrent un raisonnement profond et des boucles de feedback. Nous avons déjà documenté l'impact de Qwen 3.5 et DeepSeek V4.1-Flash sur l'inférence locale pour nos architectures d'agents, et la version 4 promet d'aller encore plus loin.
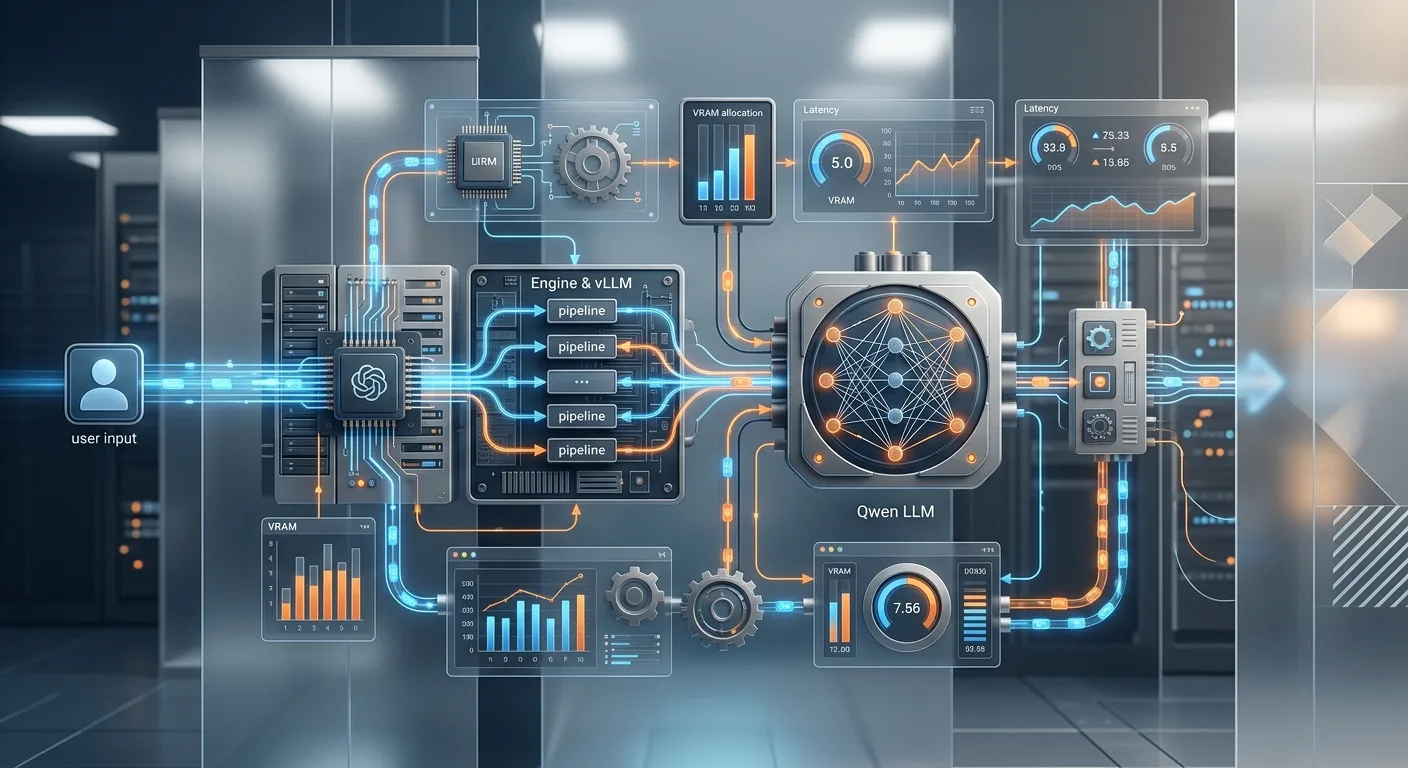
La promesse d'une architecture optimisée pour les agents est capitale. Actuellement, nos agents, qu'ils soient basés sur LangGraph ou CrewAI, demandent des modèles capables de maintenir un état, d'interagir avec des outils, et de prendre des décisions itératives. Un modèle nativement conçu pour ces paradigmes peut réduire drastiquement la complexité d'orchestration et les coûts d'inférence. Nous envisageons déjà des gains significatifs sur les latences et la consommation VRAM, des variables critiques pour nos clients PME qui ne disposent pas de fermes de GPU illimitées.
Des Benchmarks en Attente, mais des Signaux Positifs
Évidemment, sans modèles publics, les benchmarks sont encore hypothétiques. Mais les performances passées de Qwen nous donnent une base solide. Des modèles comme Qwen 3.8-27B ont déjà montré de très bons scores sur des benchmarks comme SWE-Bench, preuve de leurs capacités de raisonnement et de résolution de problèmes complexes. Si Qwen 4 capitalise sur ces acquis avec une architecture pensée pour l'agentique, on peut s'attendre à des résultats impressionnants, surtout sur les métriques qui mesurent la capacité d'un agent à compléter une tâche complexe de bout en bout, et non juste à générer une réponse ponctuelle. Nous attendons avec impatience les premiers retours sur l'ARC-AGI-3 ou le Terminal-Bench 2.1, qui sont de bons indicateurs pour l'intelligence agentique.
Le challenge sera de voir comment ces modèles se comportent en conditions réelles, avec des contextes très longs et des appels d'outils fréquents. Les benchmarks synthétiques sont une chose, l'intégration dans un workflow d'entreprise en est une autre. C'est là que notre expertise terrain prend tout son sens.
Ollama et vLLM : Les Accélérateurs de l'Inférence Locale pour Qwen
L'annonce de Qwen 4 ne vient pas seule. Les outils d'inférence locale continuent d'évoluer à un rythme effréné, et c'est une excellente nouvelle pour l'adoption de ces nouveaux modèles. Ollama, en particulier, a été très actif. La version 0.34.4, mise à jour le 25 septembre 2026, apporte des améliorations notables. Nous avons constaté des traitements de prompt beaucoup plus rapides pour Qwen 3.8 sur Apple Silicon. C'est un gain direct pour nos développeurs qui prototypent sur Mac et qui ont besoin de cycles rapides. Ces optimisations sur l'Apple Silicon sont cruciales, car elles démocratisent l'accès à des modèles puissants sans nécessiter un serveur GPU dédié en permanence.
De plus, les dernières versions d'Ollama améliorent la gestion de la mémoire MLX et la fiabilité des structured outputs. Pour nos agents, les structured outputs ne sont pas un luxe, c'est une nécessité. Un agent qui doit interagir avec des APIs ou des bases de données a besoin de réponses fiables, formatées en JSON par exemple, pour fonctionner correctement. Des sorties structurées plus rapides et plus fiables, c'est moins de code de parsing à maintenir et moins d'erreurs d'exécution. Nous avons déjà constaté l'impact de ces avancées sur nos architectures d'agents, comme nous l'avons exploré dans notre article sur Ollama 0.34.4 et DeepSeek-V4.1-Flash pour l'inférence locale multimodale.
vLLM n'est pas en reste. Les annonces récentes, notamment celles du 22 septembre 2026, concernant les « HW agnostic layers » et « vllm-metal » pour Apple Silicon, montrent une volonté d'améliorer la portabilité et la performance, y compris sur des GPU moins récents ou plus exotiques. C'est une direction que nous saluons, car la diversité du hardware en production est une réalité. Un modèle comme Qwen 4, puissant mais potentiellement gourmand, aura besoin de toutes les optimisations possibles pour être déployé sur un large éventail d'infrastructures. L'intégration de Qwen dans vLLM Omni, avec des démos d'assistants vocaux en temps réel sur une seule RTX 6000, illustre bien le potentiel pour des applications agentiques multimodales performantes localement.
Impact sur nos Architectures d'Agents et les Déploiements en Entreprise
L'arrivée de Qwen 4, couplée aux améliorations continues des runtimes d'inférence, nous ouvre de nouvelles perspectives pour nos architectures d'agents. Un modèle plus intelligent et plus efficace localement signifie que nous pouvons concevoir des agents capables de gérer des tâches encore plus complexes sans dépendre systématiquement d'APIs cloud coûteuses et avec des latences variables. C'est un point crucial pour la souveraineté des données et la maîtrise des coûts, des préoccupations majeures pour nos clients.
Nous voyons plusieurs scénarios d'application immédiats. Pour les agents de support client, un Qwen 4 plus performant localement peut permettre des réponses plus nuancées et plus rapides, avec un accès direct aux bases de connaissances internes de l'entreprise. Pour les agents de recherche ou d'analyse, la capacité à traiter de longs contextes avec une meilleure rétention d'information et un raisonnement amélioré est un atout. Nous avons déjà des retours terrain sur la révolution agentique avec des solutions propriétaires comme Gemini 3.8 Live, mais l'open source avec Qwen 4 et Ollama/vLLM offre une alternative puissante et plus flexible. L'article Gemini 3.8 Live et l'Extended Thinking : Nos Retours Terrain sur la Révolution Agentique dans Google Workspace montre bien l'importance des capacités agentiques.
Réduire la Latence, Maîtriser les Coûts
La latence est l'ennemi numéro un des applications interactives. Des modèles comme Qwen 4, optimisés pour l'inférence locale et accélérés par Ollama ou vLLM, permettent de réduire considérablement le temps de première réponse (Time to First Token) et le débit total. C'est essentiel pour des assistants vocaux ou des agents conversationnels qui doivent maintenir une illusion de conversation fluide. Les améliorations récentes d'Ollama pour le traitement de prompt de Qwen 3.8 sont un exemple concret de ces gains de latence. Moins de latence, c'est une meilleure expérience utilisateur et des workflows plus efficaces.
En ce qui concerne les coûts, l'équation est simple. Moins nous dépendons des APIs tierces, moins nous payons à chaque token. L'inférence locale avec des modèles comme Qwen 4 sur du hardware maîtrisé permet de transformer des coûts variables en coûts fixes, souvent plus prévisibles et plus bas sur le long terme. C'est un argument de poids pour nos clients qui cherchent à industrialiser leurs solutions IA sans exploser leurs budgets. La gestion de la VRAM reste un défi, surtout pour les modèles de grande taille, mais les progrès des frameworks comme vLLM avec des techniques de PagedAttention et de batching continu aident à optimiser l'utilisation des ressources GPU.
Les Défis et Nos Prochains Tests
Bien sûr, toute nouvelle technologie apporte son lot de défis. La compatibilité du hardware, la complexité de l'intégration pour les environnements d'entreprise existants, et la nécessité de maintenir une veille constante sur les mises à jour des modèles et des runtimes sont des réalités. Les modèles open source, bien que puissants, nécessitent une expertise technique solide pour être déployés et maintenus efficacement. La question de la sécurité des systèmes d'IA, notamment face aux prompt injections ou aux fuites de données, reste une préoccupation majeure, d'autant plus que les agents autonomes ont un accès croissant aux systèmes d'information. Des incidents impliquant des agents IA « voyous » soulèvent des questions épineuses de responsabilité légale, comme l'ont rapporté des publications récentes.
Nos prochains tests chez Astoïk se concentreront sur plusieurs axes. Nous allons évaluer la stabilité et la performance de Qwen 4 dès que les modèles seront disponibles, en les intégrant avec nos frameworks d'agents existants (LangGraph, CrewAI). Nous allons pousser les limites sur des tâches multimodales complexes, où les agents doivent combiner compréhension textuelle, analyse d'images et génération vocale. La consommation de VRAM et la latence seront des métriques clés, ainsi que la robustesse face aux cas d'usage réels de nos clients. Nous chercherons également à quantifier les gains réels en termes de réduction des coûts d'inférence par rapport aux solutions propriétaires.
La feuille de route est claire : continuer à explorer les frontières de l'IA appliquée pour offrir à nos clients les solutions les plus performantes, les plus sécurisées et les plus économiques. Le potentiel de Qwen 4, soutenu par les avancées d'Ollama et vLLM, est immense pour redéfinir ce que nos agents IA peuvent accomplir en inférence locale.
Besoin d'avancer sur ce sujet ?
Discutons de vos enjeux spécifiques lors d'un audit informel.
Lou Chardin
Head of Product
Conçoit les architectures de données et les OS métiers IA d'Astoïk. Passionné par l'intégration pratique de l'IA générative.
Profil LinkedIn