Qwen3.8-Flash-Next et l'Ascension des Modèles Open Source : L'Inférence Locale Redéfinie
Un vent nouveau souffle sur l'IA open source. La sortie de Qwen3.8-Flash-Next, véritable avant-goût de Qwen4, couplée aux derniers benchmarks d'Artificial Analysis, confirme une tendance lourde : les modèles à poids ouverts rattrapent les géants propriétaires. Chez Astoïk, nous observons ces évolutions avec un intérêt marqué pour nos architectures d'agents autonomes et l'optimisation des coûts d'inférence locale.
Chez Astoïk, notre quotidien est rythmé par la veille technologique. Nous scrutons chaque annonce, chaque benchmark, chaque ligne de code qui pourrait transformer nos déploiements clients. Ces dernières 48 heures, l'actualité a été particulièrement dense, confirmant des dynamiques que nous anticipions depuis un certain temps. Le constat est net : l'écosystème des grands modèles de langage (LLM) open source est en pleine effervescence, avec des avancées qui redéfinissent les stratégies d'entreprise en matière d'IA. La convergence de nouveaux modèles performants et de benchmarks de plus en plus révélateurs nous pousse à réévaluer constamment nos approches, notamment sur l'inférence locale et les architectures d'agents.
Qwen3.8-Flash-Next : Un Avant-Goût de Qwen4 et la Révolution MoE
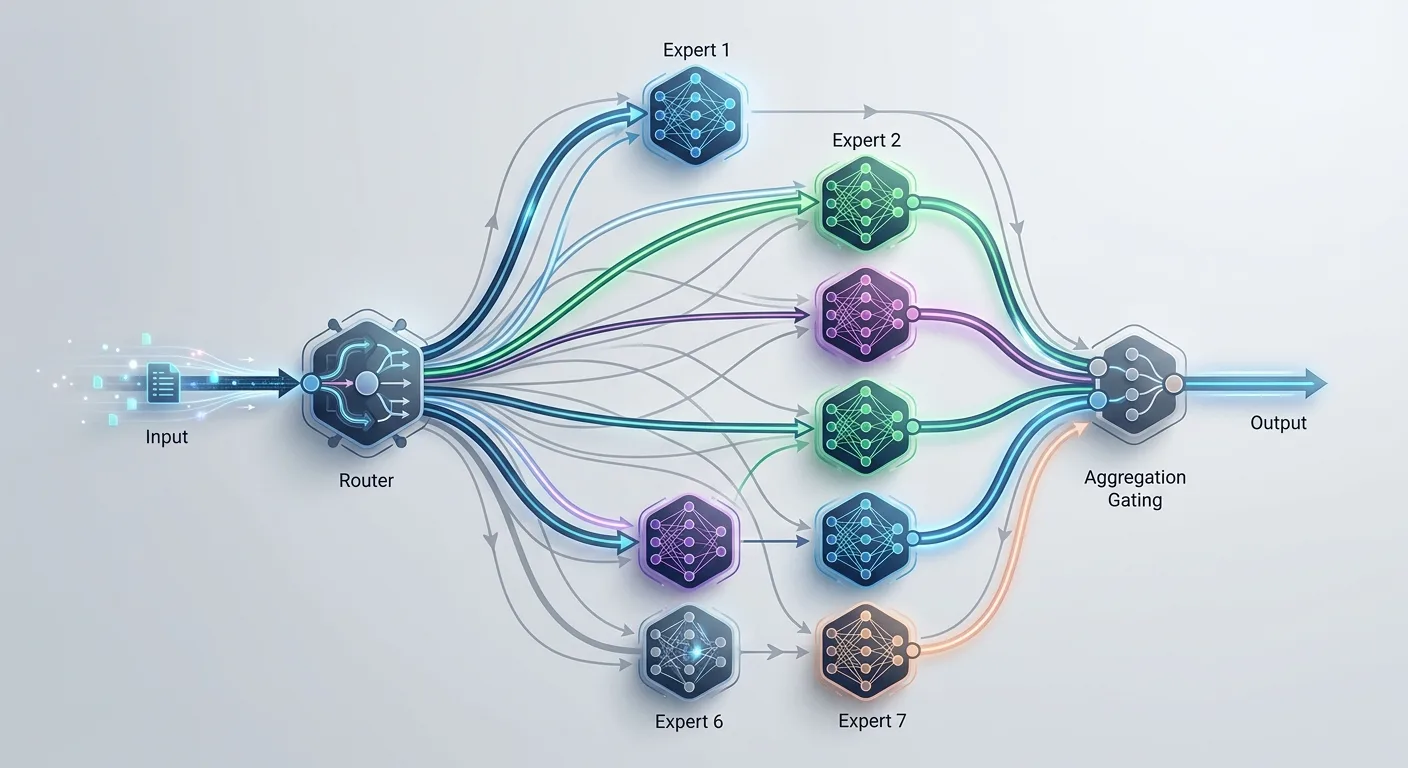
L'annonce de Qwen3.8-Flash-Next a fait l'effet d'une bombe dans la communauté open source. Ce modèle, fraîchement publié par Alibaba, n'est pas qu'une simple itération ; il est explicitement présenté comme un aperçu de l'architecture qui sera utilisée dans Qwen4. C'est un modèle Mixture-of-Experts (MoE) multimodal, un signe clair de la direction que prend l'IA générative. Ce qui nous frappe, c'est sa taille impressionnante : 125 milliards de paramètres au total. Mais là où la magie opère, c'est qu'il n'en active que 6 milliards par token. Cette approche MoE est un game-changer pour l'inférence locale. Elle permet des gains de performance notables sans exploser les besoins en VRAM, un défi constant sur nos infrastructures. On peut d'ailleurs retrouver une analyse plus approfondie de ce modèle dans notre article Qwen3.8-Flash-Next : L'Architecture de Qwen 4 Dévoilée et Ses Répercussions Immédiates pour Nos Agents IA Locaux.
Historiquement, faire tourner des modèles massifs en local était un véritable casse-tête. Les contraintes de mémoire VRAM et les coûts de calcul nous forçaient souvent à des compromis douloureux entre performance et accessibilité. Avec Qwen3.8-Flash-Next, l'équilibre semble se déplacer. Nous pouvons envisager des déploiements plus agiles, même pour des tâches complexes nécessitant une compréhension multimodale. Pour nos clients PME, cela signifie une capacité accrue à internaliser des processus d'IA, à réduire leur dépendance aux APIs tierces et, surtout, à maîtriser leurs coûts opérationnels. C'est une promesse concrète de souveraineté numérique.
L'Open Source Accélère : Les Derniers Benchmarks d'Artificial Analysis
Le rapport d'Artificial Analysis de septembre 2026 vient confirmer cette dynamique. Il montre que le meilleur modèle open source n'est plus qu'à 6 points des modèles fermés, contre 13 points il y a seulement un an. C'est une réduction de moitié de l'écart, une accélération fulgurante que peu auraient prédite il y a quelques mois. Kimi K3 de Moonshot AI se positionne comme le leader de l'open source, avec un score de 59,7 sur l'indice global, se classant septième au classement absolu et premier parmi les modèles à poids ouverts. Juste derrière, on retrouve GLM-5.3 (59,5) et Qwen3.8 Max Preview (58,1). Ces chiffres ne sont pas que des points sur un graphique ; ils traduisent une maturité technique impressionnante qui impacte directement nos choix d'architectures. L'écart se réduit, et sur certaines tâches agentiques ou de raisonnement long, les modèles fermés conservent encore une avance, mais elle se mesure désormais en mois, non plus en années.
Pour nous, ces benchmarks sont des indicateurs précieux. Ils nous guident dans la sélection des modèles les plus adaptés aux besoins spécifiques de nos clients. Nous observons que des modèles comme Kimi K3, avec ses 2,8 trillions de paramètres en open-weight et sa fenêtre de contexte d'un million de tokens, redéfinissent ce qui est possible en matière de codage agentique. C'est une capacité qui ouvre la porte à des automatisations encore plus complexes et fiables. L'ensemble de ces modèles, téléchargeables et hébergeables sur notre propre matériel, est une aubaine pour les entreprises qui cherchent à innover sans dépendre d'une infrastructure cloud coûteuse et potentiellement sujette à des verrous technologiques.
Maîtriser l'Architecture MoE : Clé de l'Efficacité pour les Agents Autonomes
L'architecture Mixture-of-Experts, ou MoE, n'est pas nouvelle, mais son implémentation dans des modèles comme Qwen3.8-Flash-Next ou Kimi K3 est en train de changer la donne. Plutôt que d'activer l'intégralité d'un réseau neuronal gigantesque pour chaque inférence, seuls quelques 'experts' sont sollicités en fonction de la tâche. Cela permet une inférence plus rapide et moins gourmande en ressources, un point capital pour les applications d'IA en entreprise. Sur nos déploiements d'agents autonomes, la latence est souvent un facteur limitant. Réduire le temps de réponse du modèle, même de quelques millisecondes, a un impact direct sur la fluidité et l'efficacité des workflows. C'est ce que nous cherchons constamment à optimiser, comme nous l'avons exploré dans des articles sur l'orchestration agentique, par exemple Google Workspace et Gemini : L'Orchestration Agentique Réinvente nos Workflows d'Entreprise.
Concrètement, un agent qui doit analyser un document, extraire des informations, puis générer une réponse ciblée, bénéficie énormément d'un modèle MoE. Chaque étape du processus peut potentiellement activer un ensemble d'experts plus pertinent, optimisant ainsi le calcul. Cela se traduit par une meilleure utilisation des GPU, une réduction des coûts par token et une capacité à gérer des volumes de requêtes plus importants. Nous avons vu des améliorations significatives sur des tâches de raisonnement complexe et de génération de code, où la précision est primordiale.
Le Défi de l'Inférence Locale : VRAM, Latence et Optimisation
L'inférence locale est au cœur de notre stratégie chez Astoïk. Elle offre une maîtrise totale des données, une sécurité renforcée et une indépendance vis-à-vis des fournisseurs cloud. Mais elle n'est pas sans défis. La performance des LLM en local ne se résume pas à la puissance brute d'un GPU. La taille du modèle, la quantification, la capacité de la VRAM, la bande passante mémoire, la longueur du contexte, la planification d'exécution (runtime scheduling) et même la topologie du système (voies PCIe, NUMA) sont autant de facteurs critiques. Nous observons souvent que les goulets d'étranglement apparaissent d'abord au niveau de la VRAM, puis de la bande passante mémoire. Ces modèles open source, de plus en plus performants et optimisés comme DeepSeek V4.1 Flash, permettent d'aller plus loin. Nous avons d'ailleurs partagé nos retours sur ce sujet dans DeepSeek V4.1 Flash : Le Nouveau Champion de l'Inférence Locale Agentique Qui Secoue le Marché.
Des outils comme `llama.cpp` et Ollama sont essentiels dans cet écosystème. `llama.cpp`, par exemple, a récemment fait l'objet de nouvelles discussions sur Hacker News, soulignant son rôle de moteur d'inférence de référence pour les modèles open-weight en local. C'est la brique sous le capot qui alimente une grande partie de l'écosystème personnel, gérant les quantifications GGUF, l'exécution CPU et GPU, et l'empreinte mémoire. La trajectoire de ces projets open source et leur indépendance sont déterminantes pour la disponibilité future des modèles quantifiés et le support matériel. La capacité à faire tourner un modèle 70B quantifié sur 32 Go de RAM unifiée, comme c'est le cas avec des optimisations GGUF pour Ollama, est une réalité qui ouvre des perspectives inédites.
Nous testons en permanence les limites de ces systèmes. Il ne s'agit pas seulement de faire tourner un modèle, mais de le faire de manière stable, avec une latence prévisible et un débit suffisant pour des charges de travail réelles. La gestion des requêtes parallèles, l'allocation mémoire et les problèmes de sortie structurée au niveau du runtime sont des points sur lesquels nous travaillons activement. L'objectif est de fournir des architectures robustes et évolutives, capables de s'adapter aux besoins changeants de nos clients.
Implications Stratégiques : Vers une Autonomie Technologique en Entreprise
L'essor des LLM open source et l'amélioration de l'inférence locale ont des implications stratégiques majeures pour les entreprises. Premièrement, c'est une opportunité sans précédent de réduire la dépendance vis-à-vis des grands acteurs du cloud et de leurs APIs propriétaires. En hébergeant les modèles en interne, nos clients reprennent le contrôle de leurs données et de leurs infrastructures. C'est un pas vers une véritable souveraineté numérique.
Deuxièmement, la maîtrise des coûts. Les modèles propriétaires sont souvent facturés au token, ce qui peut entraîner des dépenses exponentielles à mesure que l'utilisation de l'IA se généralise. Avec des modèles open source optimisés pour l'inférence locale, les coûts sont principalement liés à l'investissement initial dans le matériel et à la consommation énergétique. Sur le long terme, cette approche est souvent plus économique et prévisible, surtout pour des volumes importants de requêtes. Cela permet d'allouer plus de budget à l'innovation et moins à la simple consommation de services.
Enfin, la flexibilité et la personnalisation. Les modèles open source peuvent être fine-tunés avec des données spécifiques à l'entreprise, ce qui permet de créer des IA hautement spécialisées et performantes pour des cas d'usage métiers précis. C'est une capacité que les modèles propriétaires offrent rarement avec le même niveau de granularité et de contrôle. Chez Astoïk, nous capitalisons sur cette flexibilité pour développer des solutions sur mesure qui s'intègrent parfaitement aux workflows existants de nos clients.
La Vision Astoïk : Intégrer l'Innovation pour un Impact Réel
Chez Astoïk, notre mission est de transformer ces avancées technologiques en solutions concrètes et rentables pour nos clients. L'évolution rapide des LLM open source, notamment avec des modèles comme Qwen3.8-Flash-Next et les performances affichées par Kimi K3, renforce notre conviction que l'avenir de l'IA en entreprise passe par une approche hybride et pragmatique. Nous combinons le meilleur de l'open source avec des architectures robustes pour construire des systèmes d'agents autonomes qui apportent une réelle valeur ajoutée.
Nous continuons à explorer et à pousser les limites de l'inférence locale, en optimisant nos stacks techniques pour tirer le meilleur parti de ces nouveaux modèles. Cela implique de jongler avec les formats de quantification (GGUF), les moteurs d'inférence (Ollama, `llama.cpp`), et les différentes contraintes matérielles. L'objectif est toujours le même : offrir des solutions performantes, sécurisées et économiquement viables. Ces derniers développements ne font que confirmer que nous sommes sur la bonne voie, en proposant à nos clients une véritable alternative aux solutions propriétaires, avec une flexibilité et une maîtrise inégalées.
La course à l'IA ne ralentit pas. Nous restons en première ligne, prêts à intégrer ces innovations pour faire de l'intelligence artificielle un levier de croissance et d'efficacité pour chaque entreprise que nous accompagnons. C'est un engagement constant, nourri par une veille technologique sans relâche et une expertise technique pointue.
Besoin d'avancer sur ce sujet ?
Discutons de vos enjeux spécifiques lors d'un audit informel.
Lou Chardin
Head of Product
Conçoit les architectures de données et les OS métiers IA d'Astoïk. Passionné par l'intégration pratique de l'IA générative.
Profil LinkedIn