
DeepSeek-V4.1-Flash 1017 : Le Modèle Qui Accélère l'Agentique Locale, Nos Premiers Retours
Une mise à jour majeure vient de secouer le monde des LLMs open source. DeepSeek-V4.1-Flash 1017, tout juste sorti, promet de redéfinir l'inférence locale agentique. Chez Astoïk, nous avons plongé dans les benchmarks et les implications concrètes pour nos déploiements clients.
L'actualité IA, c'est un flux tendu. Ça bouge vite, très vite. On est constamment à l'affût, scrutant la moindre annonce qui peut transformer nos architectures ou offrir de nouvelles perspectives à nos clients. Ces dernières 48 heures, un nom est revenu avec insistance dans nos fils de veille : DeepSeek. Plus précisément, la version DeepSeek-V4.1-Flash 1017. C'est le genre de sortie qui ne fait pas les gros titres du grand public, mais qui, pour nous, architectes techniques et Head of Product, représente un changement de donne potentiel pour l'inférence locale et les systèmes d'agents autonomes.
On parle ici d'un modèle qui, sur le papier, semble taillé pour les charges de travail agentiques gourmandes. Et c'est exactement là que nos clients, des PME souvent, cherchent de la valeur. Moins dépendre des APIs propriétaires, maîtriser les coûts, garantir la confidentialité des données. C'est notre credo chez Astoïk. Alors, quand une mise à jour comme celle-ci arrive, on ne se contente pas de lire les communiqués. On creuse, on teste, on confronte avec nos retours terrain.
DeepSeek-V4.1-Flash 1017 : Une Évolution Axée sur l'Agentique
La sortie de DeepSeek V4.1 Flash 1017 le 17 octobre 2026 n'est pas juste un numéro de version de plus. C'est une affirmation claire de la direction que prend DeepSeek : l'efficacité pour les tâches complexes, notamment le codage et les workflows agentiques efficaces. Ce modèle, avec ses 552 milliards de paramètres totaux, active 8 milliards en préremplissage et 16 milliards en décodage, tout en gérant un contexte d'un million de jetons. Des chiffres qui parlent d'eux-mêmes pour l'ingénieur.
Ce qui nous intéresse particulièrement, c'est sa performance sur des benchmarks spécifiques. Le modèle affiche un score impressionnant de 90.6 sur Terminal-Bench 2.1 et 74.2 sur DeepSWE v1.1, selon les rapports du fournisseur. Ces métriques sont cruciales. Elles ne mesurent pas seulement la capacité à générer du texte, mais la profondeur de raisonnement, la capacité à comprendre et à exécuter des instructions complexes, ce qui est le pain quotidien des agents autonomes. La version GA de DeepSeek V4 Pro, mise à jour le 17 octobre 2026, met en avant des capacités d'agent grandement améliorées, avec des gains de performance notables dans les environnements de production. C'est ce qu'on attend d'un modèle de cette envergure.
La licence MIT est un atout majeur. C'est une liberté précieuse pour les entreprises qui veulent intégrer ces modèles sans les contraintes des licences propriétaires. Cela ouvre la porte à des personnalisations profondes, à l'entraînement sur des données sensibles en interne, sans fuite d'information. C'est un argument de poids pour nos clients qui privilégient la souveraineté de leurs données et la flexibilité de leurs infrastructures.
Le Focus sur l'Agentique Multimodale
On observe aussi un effort vers l'agentique multimodale. La version 'Vision-Exp' de DeepSeek-V4-Flash se positionne pour des capacités d'agent multimodal proches d'Opus-4.8, ce qui est une avancée significative. Pour nos déploiements où l'agent doit interagir avec des documents, des schémas ou des images, cette multimodalité native est un game changer. Elle simplifie l'architecture, réduit la complexité d'intégration de modules distincts pour la vision et le langage.
Les agents ne se contentent plus de comprendre du texte. Ils doivent voir, analyser des graphiques, des tableaux, des interfaces. Cette capacité intégrée, si elle tient ses promesses en production, pourrait bien faire de DeepSeek-V4.1-Flash un choix privilégié pour les applications d'automatisation avancée et d'analyse de données non structurées, là où l'humain passe encore beaucoup de temps.
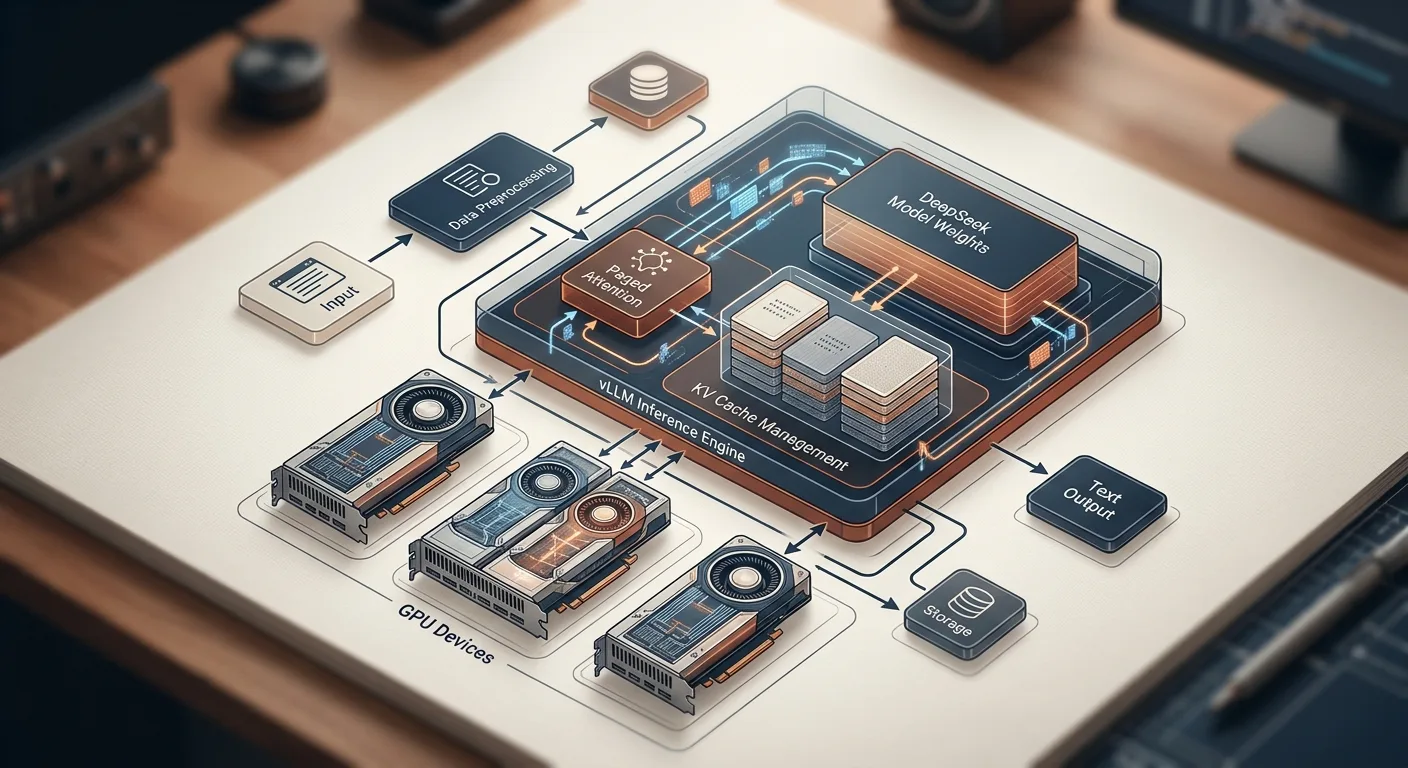
vLLM et DeepSeek : L'Inférence Locale au Sommet de sa Forme
Parler de DeepSeek-V4.1-Flash sans mentionner vLLM, c'est ne pas comprendre la synergie. vLLM est notre moteur d'inférence de prédilection pour les LLMs, et son support optimisé pour DeepSeek-V4.1-Flash est un facteur clé de notre enthousiasme. Nous avons déjà documenté comment DeepSeek-V4.1-Flash-1017 et vLLM ont permis à l'inférence locale agentique d'atteindre un nouveau sommet. C'est une combinaison qui maximise le débit et réduit la latence, des points critiques pour tout système en production.
Le blog de vLLM, le 7 octobre 2026, a d'ailleurs mis en avant un gain de 5x en débit agentique pour DeepSeek-V4.1-Flash depuis le premier jour de support. Un facteur cinq. C'est énorme. Cela signifie qu'on peut traiter cinq fois plus de requêtes par seconde sur le même hardware, ou réduire drastiquement le coût par inférence. Pour une PME, c'est la différence entre un projet IA viable et un gouffre financier. Ces optimisations continues de vLLM, notamment via des innovations comme PagedAttention et le continuous batching, sont essentielles pour les charges de travail les plus exigeantes.
Nous avons déjà exploré en profondeur comment vLLM et DeepSeek-V4.1-Flash redéfinissent le débit agentique local grâce aux transferts KV bidirectionnels. C'est une prouesse technique qui minimise les mouvements de données et optimise l'utilisation de la VRAM. Sur nos serveurs équipés de cartes NVIDIA, on voit la différence. La gestion de la mémoire, les stratégies de caching, tout est conçu pour pousser les limites de l'inférence locale. C'est un travail d'orfèvre qui se traduit par des gains tangibles sur nos déploiements.
L'Impact des Mises à Jour de vLLM
Les mises à jour de vLLM ne s'arrêtent pas là. La feuille de route pour le quatrième trimestre 2026 met l'accent sur l'optimisation des charges de travail agentiques, avec un focus sur les performances 'day-0', les recettes de production optimisées, le décodage spéculatif adaptatif et la tolérance aux pannes sur différents matériels. C'est une approche holistique qui garantit que des modèles comme DeepSeek-V4.1-Flash sont non seulement performants, mais aussi robustes et faciles à déployer à grande échelle.
Intel a également contribué à cet écosystème avec la sortie de LLM-Scaler-vLLM PV 1.5 le 16 octobre 2026, intégrant vLLM 0.26 et améliorant la prise en charge de modèles comme Qwen et Gemma 4, notamment pour le temps de premier jeton et le cache KV FP8. Bien que ce ne soit pas directement DeepSeek, cela montre la convergence des efforts pour rendre l'inférence locale toujours plus accessible et performante, même sur du hardware moins conventionnel comme les cartes Intel Arc Graphics.
Au-delà des Benchmarks : Ce Que Ça Change pour Nos Déploiements
Pour nous, chez Astoïk, ces annonces ne sont pas que des chiffres dans un tableau. Elles se traduisent par des réalités concrètes sur nos déploiements clients. Un modèle comme DeepSeek-V4.1-Flash 1017, couplé à vLLM, signifie que nous pouvons proposer des solutions plus puissantes, plus rapides et surtout, plus économiques. La promesse d'un débit agentique multiplié par cinq, comme nous l'avons vu dans notre analyse sur le débit agentique multiplié par cinq avec DeepSeek-V4.1-Flash et vLLM, n'est pas anodine.
C'est moins de GPU à provisionner, donc des coûts d'infrastructure réduits. C'est une latence plus faible, ce qui rend les interactions avec les agents plus fluides et plus naturelles. Pour des applications de support client, d'automatisation de tâches administratives ou de génération de code, c'est un avantage concurrentiel direct. Nos PME clientes peuvent ainsi se doter de capacités IA de pointe sans exploser leurs budgets, un point essentiel pour leur compétitivité.
L'inférence locale avec ces modèles open source nous donne aussi un contrôle total sur la chaîne de valeur. Pas de dépendance à une API externe qui peut changer ses tarifs ou ses politiques du jour au lendemain. Pas de risque de voir nos prompts ou les données de nos clients transiter par des serveurs tiers. La sécurité et la confidentialité sont au cœur de nos préoccupations, et ces technologies y répondent parfaitement.
Le Cas des Agents Autonomes en Entreprise
Les systèmes d'agents autonomes sont un axe majeur pour nous. Que ce soit avec CrewAI, LangGraph ou AutoGen, l'orchestration de plusieurs agents nécessite des modèles d'inférence sous-jacents extrêmement performants. DeepSeek-V4.1-Flash 1017, avec ses capacités agentiques renforcées, devient un candidat de choix pour motoriser ces architectures multi-agents. Un agent qui doit lire un document, extraire des informations, prendre une décision et interagir avec un système métier a besoin d'une inférence rapide et précise. C'est ce que nous offre ce type de modèle.
Sur nos projets récents, nous avons pu constater que la performance brute d'un LLM est une chose, mais sa capacité à s'intégrer efficacement dans un pipeline agentique en est une autre. La robustesse face aux requêtes complexes, la gestion des erreurs, la capacité à maintenir le contexte sur de longues séquences d'échanges, sont autant de points où DeepSeek-V4.1-Flash, optimisé par vLLM, montre un avantage clair. On peut construire des agents plus intelligents, plus autonomes, avec une meilleure résilience.
Les Défis Restants et Notre Vision Astoïk
Bien sûr, tout n'est pas rose. Le déploiement de ces modèles en production, même avec des outils comme vLLM, reste un défi technique. Il faut une expertise pointue pour optimiser le hardware, gérer les caches KV, monitorer la latence et le débit en temps réel. La VRAM reste une ressource précieuse, et même avec des optimisations, les grands modèles nécessitent des GPU performants. On ne déploie pas un DeepSeek-V4.1-Flash sur un Raspberry Pi, soyons clairs.
Les coûts initiaux d'acquisition du matériel peuvent être un frein pour certaines structures. C'est pourquoi nous travaillons à des architectures hybrides, où certains agents critiques tournent en local, et d'autres, moins sensibles ou moins exigeants en ressources, peuvent s'appuyer sur des APIs cloud. L'équilibre est fragile, mais c'est notre rôle de le trouver pour nos clients.
La conformité réglementaire, notamment avec l'EU AI Act, ajoute une couche de complexité. Avoir des modèles open source, dont on peut inspecter les poids et les données d'entraînement (quand elles sont disponibles), est un avantage indéniable pour l'auditabilité et la transparence. C'est un argument fort pour le choix de l'open source face aux boîtes noires propriétaires.
L'Avenir de l'Inférence Locale Agentique
L'avenir de l'inférence locale agentique est prometteur. L'écosystème autour de vLLM, Ollama et des modèles comme DeepSeek, Mistral ou Qwen ne cesse de s'améliorer. Nous voyons de plus en plus de modèles spécialisés émerger, chacun avec ses forces et faiblesses. Le défi est de choisir le bon outil pour le bon problème, et de l'intégrer de manière transparente dans les systèmes existants. C'est là qu'intervient notre expertise d'architecte technique.
Nous continuons d'expérimenter avec des bases de données vectorielles pour le RAG (Retrieval Augmented Generation), des orchestrateurs comme LangChain ou LlamaIndex, et des outils d'automatisation comme n8n ou Make pour connecter ces intelligences aux systèmes métiers. Chaque brique est essentielle, et l'amélioration d'un composant comme DeepSeek-V4.1-Flash 1017 a des répercussions positives sur l'ensemble de la chaîne.
En Bref : Une Avancée Majeure pour l'IA d'Entreprise
Pour conclure, la sortie de DeepSeek-V4.1-Flash 1017, couplée aux avancées continues de vLLM, est une excellente nouvelle pour l'IA d'entreprise. C'est une brique de plus, et une brique solide, pour construire des systèmes d'IA plus performants, plus autonomes et plus contrôlables en local. Cela renforce notre conviction que l'open source, avec une bonne dose d'ingénierie, est la voie à suivre pour démocratiser l'IA appliquée et la rendre accessible à toutes les entreprises. Le travail ne manque pas, mais les outils sont de plus en plus affûtés.
Besoin d'avancer sur ce sujet ?
Discutons de vos enjeux spécifiques lors d'un audit informel.
Lou Chardin
Head of Product
Conçoit les architectures de données et les OS métiers IA d'Astoïk. Passionné par l'intégration pratique de l'IA générative.
Profil LinkedIn