
vLLM et DeepSeek-V4.1-Flash : Le Débit Agentique Local Redéfini par les Transferts KV Bidirectionnels
Les dernières 48 heures ont été riches en avancées pour l'inférence locale d'agents IA. vLLM vient de pousser des optimisations majeures pour DeepSeek-V4.1-Flash, notamment avec des mécanismes de transfert KV bidirectionnel. Cela change radicalement la donne pour nos déploiements en entreprise.
L'urgence de l'inférence locale performante pour les agents IA
Chez Astoïk, nous le savons bien : la course à l'IA ne se joue plus uniquement sur les modèles de fondation bruts. L'enjeu est désormais dans l'exécution. C'est la capacité à déployer ces modèles de manière efficiente, sécurisée et, surtout, localement, qui fait la différence sur le terrain. Les dernières annonces concernant vLLM et DeepSeek-V4.1-Flash nous confirment cette tendance avec une acuité particulière.
Nous avons vu le potentiel des agents autonomes. On en parle beaucoup, mais la réalité de leur déploiement en production, surtout pour des cas d'usage multi-tours ou à longue persistance, reste un défi. Le coût des API cloud, la latence, et les contraintes de souveraineté des données nous poussent constamment à explorer les limites de l'inférence locale. C'est là que des projets comme vLLM deviennent absolument centraux dans nos architectures.
DeepSeek-V4.1-Flash sur vLLM : un bond de géant pour le débit agentique
Il y a quelques jours, vLLM a fait une annonce qui a fait grand bruit dans nos équipes : le support de DeepSeek-V4.1-Flash a été optimisé de manière drastique. Le constat est sans appel : un « 5x Agentic Throughput Since Day 0 » sur le benchmark SemiAnalysis AgentX. C'est une multiplication par cinq du débit pour les tâches agentiques. Cinq fois. Cela signifie concrètement qu'un même hardware peut gérer cinq fois plus de requêtes d'agents, ou que des tâches complexes s'exécutent en une fraction du temps habituel. Pour nous, c'est une révolution pour nos clients PME qui veulent des agents performants sans exploser leur budget GPU.
DeepSeek-V4.1-Flash est déjà un modèle impressionnant par son architecture, notamment son approche causal encoder-decoder (CED) qui active intelligemment les paramètres. Il utilise 16 milliards de paramètres par token en phase de décodage, mais seulement 8 milliards pendant le pré-remplissage. Cette efficacité est cruciale pour les tâches agentiques à long horizon. Mais ce sont les optimisations de vLLM qui exploitent pleinement ce potentiel. Les développeurs de vLLM ont intégré des noyaux spécifiques à DeepSeek-V4.1-Flash, des techniques de caching des poids pour les redémarrages à chaud, et une nouvelle version du Model Runner V2 pour le décodage spéculatif.
Nous avons déjà beaucoup écrit sur l'importance de DeepSeek-V4.1-Flash et vLLM. Le potentiel de débit agentique local redéfini était déjà palpable. Ces nouvelles optimisations viennent juste de confirmer nos intuitions les plus optimistes.
Le transfert KV bidirectionnel : la clé de la performance multi-tours
La véritable pépite des dernières mises à jour de vLLM réside dans les mécanismes de transfert KV (Key-Value) bidirectionnel. C'est un point technique, mais il est fondamental pour comprendre ce qui se passe. Imaginez un agent qui discute avec un utilisateur, ou qui exécute une série de tâches qui s'appuient sur un contexte conversationnel. À chaque tour de dialogue, ou à chaque nouvelle étape de la tâche, le modèle doit se souvenir de ce qui a été dit ou fait précédemment. C'est le rôle du cache KV.
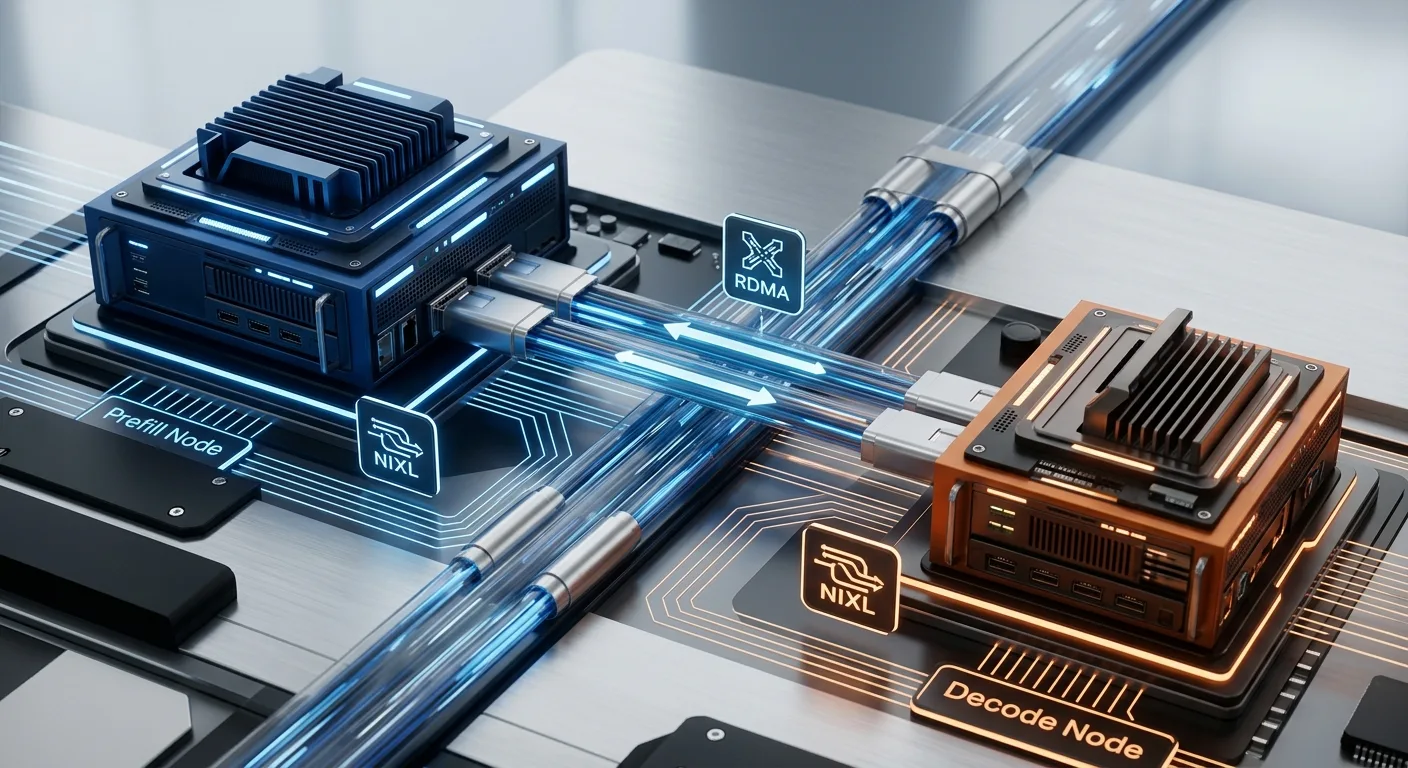
Traditionnellement, dans une architecture d'inférence distribuée, le pré-remplissage (préfet) et le décodage peuvent se produire sur des instances différentes. Le problème survient lorsque l'agent doit réutiliser des informations d'une conversation précédente. Il fallait souvent re-calculer une partie du contexte, ce qui entraînait une latence et une consommation de ressources inutiles. Avec le transfert KV bidirectionnel, les nœuds de pré-remplissage peuvent maintenant réutiliser le cache KV précédemment calculé par les nœuds de décodage lors des tours de conversation suivants. Cela coupe court aux calculs redondants de pré-remplissage et réduit le Time-To-First-Token (TTFT) jusqu'à 3,3 fois sur les invites multi-tours longues.
C'est une avancée significative pour les architectures multi-agents et les applications d'entreprise qui nécessitent des interactions longues et complexes. Fini les agents qui « oublient » une partie de leur contexte ou qui peinent à maintenir une conversation fluide sur plusieurs heures. C'est exactement le genre d'optimisation que nous cherchons pour nos déploiements réels. Nous en parlions déjà avec le transfert KV bidirectionnel comme un game changer.
Implications techniques : NIXL, RDMA et l'efficacité GPU
Allons plus loin dans la technique. Cette amélioration n'est pas magique. Elle s'appuie sur des technologies de pointe. vLLM utilise un connecteur NIXL (NVIDIA Interconnect eXchange Layer) basé sur le push pour le serving désagrégé. Concrètement, l'instance de pré-remplissage écrit directement le cache KV dans la mémoire de décodage via RDMA (Remote Direct Memory Access). Cela élimine des étapes intermédiaires comme le relais par le routeur, l'allocation côté décodage et la configuration du transfert, qui étaient auparavant sur le chemin critique du TTFT. Moins d'étapes, moins de latence. Le résultat est palpable.
C'est un travail d'ingénierie profond qui touche à l'optimisation des transferts de données entre GPU et entre instances de calcul. Pour nos clients qui investissent dans des infrastructures GPU, cela signifie un ROI bien meilleur. Chaque milliseconde gagnée sur le TTFT, chaque Mo de VRAM mieux géré, se traduit par des économies substantielles et une meilleure expérience utilisateur. Nous avons d'ailleurs pu observer des gains de performance encore plus marqués sur des architectures spécifiques comme la NVIDIA Vera Rubin NVL72, où vLLM a démontré un débit 7,8 fois supérieur au GB200 NVL72 sur AgentX. C'est une prouesse qui met en lumière l'importance de l'optimisation logicielle et matérielle conjointe.
Le rôle d'Ollama et l'écosystème de l'inférence locale
Bien sûr, vLLM n'est pas le seul acteur. Ollama continue de simplifier l'accès aux modèles open-source en local. Les dernières mises à jour d'Ollama, datant d'octobre, incluent le support de Google Gemma 2 et d'OpenAI gpt-oss, ainsi qu'une compatibilité avec l'API Anthropic Messages pour des outils comme Claude Code. C'est une excellente nouvelle pour les développeurs qui veulent expérimenter rapidement avec différents modèles sans se soucier des complexités de l'installation et de la configuration des runtimes d'inférence. La synergie entre ces outils est clé.
Cependant, pour les déploiements d'entreprise où la performance brute, la gestion fine des ressources et la résilience sont primordiales, vLLM reste souvent notre choix privilégié. Ollama est fantastique pour la phase de prototypage et pour les usages plus légers, mais dès qu'on touche à des charges agentiques lourdes, avec des millions de tokens à traiter et des exigences de latence strictes, les optimisations de bas niveau de vLLM prennent le dessus. On voit aussi des ponts se créer, comme la possibilité de faire tourner DeepSeek et Qwen au sein de Claude Desktop via Ollama 0.33, ce qui est très pratique pour intégrer le meilleur des deux mondes.
Au-delà de la performance : les agents IA et la souveraineté
Ces avancées techniques ont des implications qui dépassent la simple performance. Elles renforcent l'argument en faveur de l'IA souveraine. En nous permettant de faire tourner des modèles aussi puissants que DeepSeek-V4.1-Flash avec une telle efficacité en local, vLLM nous donne les moyens de garder le contrôle total sur nos données et nos processus. C'est un argument de poids pour nos clients dans la finance, la santé ou l'administration, où la conformité réglementaire est une priorité absolue. L'EU AI Act, par exemple, met une pression croissante sur la traçabilité et le contrôle des systèmes d'IA. L'inférence locale est une réponse directe à ces préoccupations.
Cela ouvre la porte à des architectures d'agents plus robustes et plus fiables. Nous l'avons souvent dit : l'ère des agents ne fait que commencer. La révolution agentique prend corps, et elle s'appuie sur ces briques techniques solides. Que ce soit pour des assistants de code, des systèmes d'automatisation de processus métier ou des agents de recherche complexes, avoir un contrôle fin sur la performance et la sécurité est non négociable. Les incidents récents où des agents IA ont sondé des sites gouvernementaux, même de manière involontaire, soulignent l'impératif de maîtriser ces technologies. La sécurité est une couche transversale que nous intégrons dès la conception.
Notre perspective chez Astoïk : vers des architectures agentiques hybrides
Nous ne sommes pas dans une logique de tout local ou tout cloud. La réalité de l'entreprise est plus nuancée. Nous nous orientons vers des architectures agentiques hybrides. Les modèles propriétaires comme ChatGPT 5.3 (dont nous avons fait une analyse technique de la mise à jour majeure) ou Gemini ont leur place pour des tâches spécifiques nécessitant des capacités de raisonnement très avancées ou l'accès à des données propriétaires du fournisseur. Mais pour l'exécution répétitive, la gestion de données sensibles, ou les workflows à haute fréquence, le local s'impose.
Ces avancées dans vLLM et DeepSeek-V4.1-Flash renforcent cette stratégie hybride. Elles nous donnent les outils pour construire des agents qui peuvent basculer intelligemment entre des ressources locales optimisées et des services cloud, en fonction des exigences de la tâche : coût, latence, confidentialité, et complexité. Le futur des agents IA en entreprise est dans cette flexibilité, cette capacité à orchestrer un écosystème de modèles et de runtimes pour obtenir le meilleur ROI possible, avec un contrôle total. C'est notre mission chez Astoïk : transformer ces innovations techniques en solutions concrètes et mesurables pour nos clients.
Besoin d'avancer sur ce sujet ?
Discutons de vos enjeux spécifiques lors d'un audit informel.
Lou Chardin
Head of Product
Conçoit les architectures de données et les OS métiers IA d'Astoïk. Passionné par l'intégration pratique de l'IA générative.
Profil LinkedIn