
DeepSeek-V4.1-Flash-1017 et vLLM : L'Inférence Locale Agentique Atteint un Nouveau Sommet
La sortie de DeepSeek-V4.1-Flash-1017, combinée aux optimisations de vLLM, redéfinit ce que nous pensions possible pour l'inférence locale et les systèmes d'agents. Nous observons des gains de performance massifs et une réduction des coûts qui transforment nos déploiements clients. C'est une avancée capitale pour l'autonomie et la souveraineté des données en entreprise.
Le monde de l'IA bouge vite. Chaque jour apporte son lot d'annonces, de benchmarks, de promesses. Mais ces dernières 48 heures, quelque chose de vraiment significatif s'est produit pour l'inférence locale et les systèmes d'agents autonomes. La mise à jour DeepSeek-V4.1-Flash-1017, couplée aux optimisations continues de vLLM, vient de redéfinir les standards. Chez Astoïk, nous suivons cela de très près, car l'impact sur nos déploiements clients est direct et mesurable.
DeepSeek-V4.1-Flash-1017 : Une Mise à Jour Incendiaire pour l'IA Locale
Le 17 octobre 2026, DeepSeek a frappé fort avec la version -1017 de son modèle V4.1-Flash. Ce n'est pas une simple révision. C'est un bond en avant substantiel pour les tâches de raisonnement, de codage, les workflows agentiques et même les benchmarks visuels. Ce qui nous intéresse particulièrement, c'est la réduction du temps d'exécution des tâches et de la longueur des sorties. Cela signifie des tâches accomplies plus vite et à moindre coût, un point critique pour nos clients PME.
Les Chiffres Parlent d'Eux-mêmes : Performance et Efficacité
Les benchmarks internes de DeepSeek sont éloquents. Sur Terminal-Bench 4.0, un test mesurant la complétion de tâches en ligne de commande, le score a bondi de 31.2 à 42.3. Pour DeepSWE v1.1, nous passons de 74.2 à 77.0. Ces améliorations sont loin d'être marginales. Elles positionnent DeepSeek-V4.1-Flash-1017 devant des modèles plus imposants comme Claude Opus 5 et GPT 5.6-Sol sur plusieurs catégories de codage et d'agents IA. La compression du cache KV est au cœur de cette prouesse technique, permettant de gérer une fenêtre contextuelle d'un million de jetons tout en maintenant une efficacité redoutable. C'est une capacité essentielle pour les documents longs et les tâches agentiques multi-étapes.
DeepSeek a également ouvert son moteur de recherche interne aux développeurs via de nouvelles API Search et Fetch. Cela démontre une stratégie claire : fournir des outils complets pour des applications IA de plus en plus sophistiquées. L'accent est mis sur l'amélioration continue de l'efficacité, avec des sorties plus courtes pour une précision équivalente ou supérieure, réduisant directement les coûts de jetons et la latence par tâche.
vLLM et DeepSeek : Le Couplage Qui Multiplie les Débits Agentiques

Au-delà de la mise à jour du modèle lui-même, il y a la synergie avec vLLM. Début octobre, vLLM a publié une série d'optimisations spécifiquement pour DeepSeek-V4.1-Flash. Ces travaux ont mené à une amélioration du débit agentique de 5x et une accélération de 1.9x à faible concurrence. Ces chiffres, nous les avons constatés sur nos propres plateformes. C'est un changement radical pour la capacité de nos systèmes à gérer un volume élevé de requêtes complexes.
La Synergie Technique Derrière les Gains de Throughput
Comment cela est-il possible ? Plusieurs innovations techniques sont en jeu. DeepSeek-V4.1-Flash utilise une architecture de type Codeur-Décodeur Causal (CED) qui active 16 milliards de paramètres par jeton pendant le décodage, mais seulement 8 milliards pendant le pré-remplissage. Cette architecture est extrêmement économe en mémoire. Elle intègre des techniques comme le Compressed Sparse Attention 2 (CSA2), le cache KV FP4, et le partage de cache KV inter-couches, réduisant l'empreinte globale du cache KV à seulement 890 octets par jeton. C'est une prouesse d'ingénierie qui débloque des performances jusqu'alors inaccessibles en inférence locale.
Les équipes d'Inferact et de la communauté vLLM ont intégré des noyaux (kernels) récemment publiés par DeepSeek, dont MegaAttention, Mega-mHC et DeepSelect. Ces noyaux, combinés à des optimisations comme le SWA bounded replay et les CUDA graphs, ont permis de réduire le temps au premier jeton (TTFT) de 30% et d'améliorer considérablement le débit. Si vous voulez plonger dans les détails, nous avons déjà exploré ces mécanismes en profondeur, notamment vLLM et DeepSeek-V4.1-Flash, le débit agentique local redéfini par les transferts KV bidirectionnels. C'est la base de ces performances.
Pourquoi Cette Révolution de l'Inférence Locale Nous Impacte Directement
Chez Astoïk, l'inférence locale n'est pas une lubie. C'est une nécessité stratégique pour beaucoup de nos clients. Les modèles open-source, comme DeepSeek, rivalisent désormais avec la qualité des modèles cloud, mais avec des avantages distincts. Le coût est un facteur énorme. Les API cloud peuvent devenir prohibitifs à grande échelle. Avec DeepSeek-V4.1-Flash-1017 et vLLM, nous pouvons déployer des solutions IA sophistiquées directement sur l'infrastructure de nos clients. Cela se traduit par des factures API réduites à zéro et un contrôle total sur les données. La souveraineté des données, la latence minimale et la personnalisation poussée deviennent la norme, non l'exception.
Moins de Coûts, Plus de Contrôle : Les Promesses Tenues
Nous voyons nos clients, des PME aux grands comptes, s'affranchir des contraintes des services tiers. Un modèle comme DeepSeek-V4.1-Flash-1017, optimisé par vLLM, peut fonctionner sur des GPU comme les NVIDIA A100 ou H100. Cela ouvre la porte à des applications d'IA générative complexes, des agents de support client aux assistants de développement de code, sans envoyer de données sensibles à l'extérieur. C'est une question de confiance et de performance. Nous avons d'ailleurs déjà souligné pourquoi DeepSeek-V4.1-Flash est un champion de l'inférence locale, et cette nouvelle mise à jour ne fait que confirmer notre analyse.
La performance, c'est aussi la vitesse. Une latence faible est essentielle pour les systèmes d'agents autonomes qui nécessitent des boucles de rétroaction rapides. Les optimisations de vLLM sur DeepSeek réduisent le "time to first token" de manière drastique, ce qui rend l'expérience utilisateur fluide et les agents plus réactifs. C'est particulièrement vrai pour les cas d'usage où le temps de réponse est critique, comme la génération de code en temps réel ou l'analyse de documents volumineux.
Les Ingénieurs Face aux Défis : Au-delà des Benchmarks
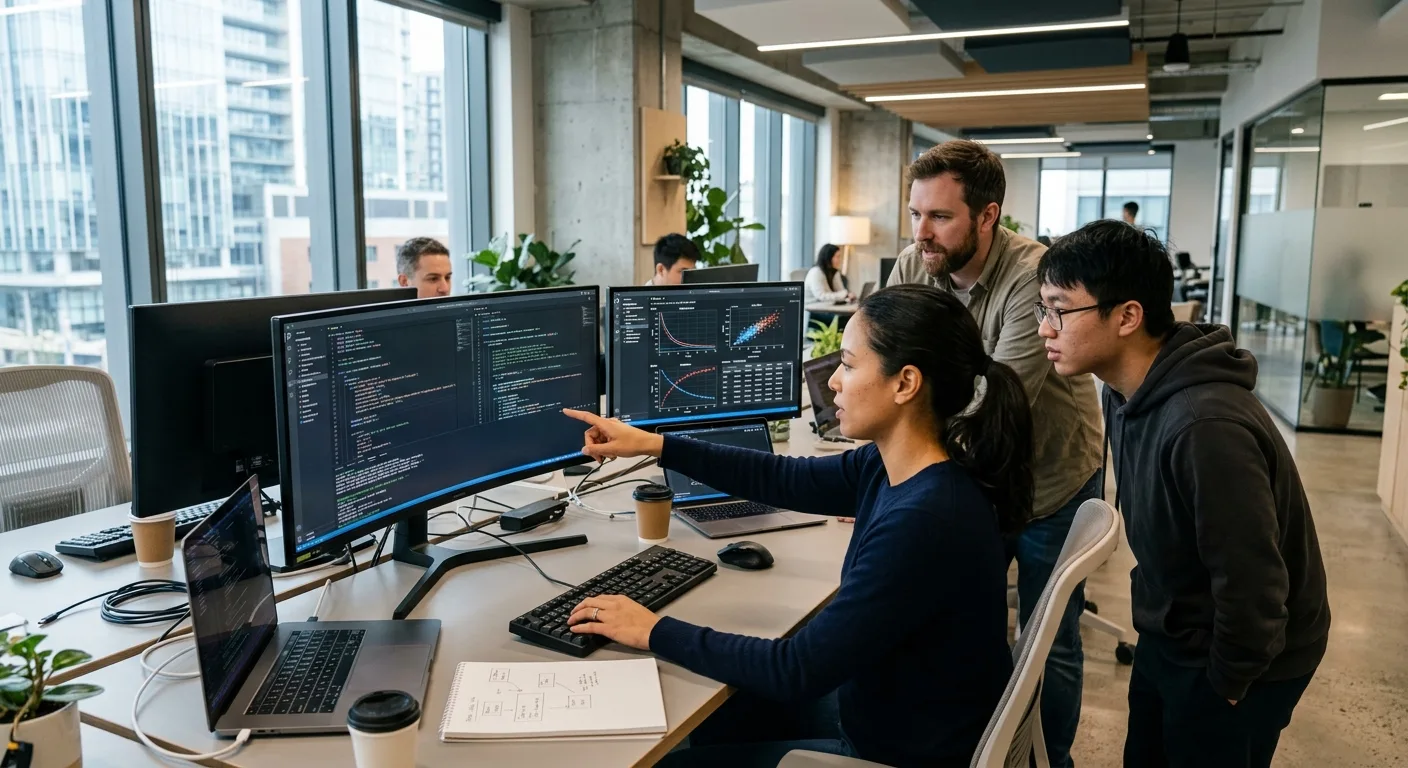
Il est facile de s'enthousiasmer pour les chiffres des benchmarks. La réalité terrain, c'est autre chose. Déployer ces modèles en production demande une expertise technique pointue. Il ne suffit pas de télécharger le modèle et de lancer un script. Il faut dimensionner l'infrastructure, gérer la mémoire VRAM, configurer vLLM avec les bonnes versions et les bons paramètres (par exemple, la branche principale de vLLM Ascend à partir du 11 septembre 2026 est requise pour DeepSeek-V4.1-Flash). Nous parlons ici de gestion de clusters GPU, de pipelines d'intégration continue, et de monitoring avancé pour garantir la stabilité et la performance.
Optimisation et Intégration en Environnement de Production
Nos équipes passent des heures à optimiser les configurations. Cela implique de choisir la bonne quantification (FP8 par exemple), d'exploiter pleinement les Tensor Cores des GPU et d'adapter les algorithmes de planification de batchs dynamiques. Pour la persistance des données et l'orchestration des agents, nous utilisons des bases de données robustes. PostgreSQL est notre choix pour les données structurées, Redis pour le caching rapide et la gestion des sessions, et des bases de données vectorielles comme Pinecone pour les architectures RAG, même si ce n'est pas le sujet principal aujourd'hui. L'intégration d'APIs tierces, de webhooks, et l'orchestration multi-agents via des outils comme LangGraph ou CrewAI deviennent plus fluides quand le moteur d'inférence sous-jacent est aussi performant et fiable.
Nous rencontrons aussi des bugs, des incompatibilités inattendues. C'est le quotidien de l'ingénierie. Un modèle aussi récent nécessite une veille constante et une capacité d'adaptation rapide. Il y a toujours une courbe d'apprentissage. Mais les bénéfices, en termes de performance et de coûts, justifient amplement l'investissement technique.
Notre Vision Chez Astoïk : Tracer la Voie de l'Agentique d'Entreprise
Cette vague d'innovations autour de DeepSeek-V4.1-Flash-1017 et vLLM conforte notre stratégie chez Astoïk. Nous sommes convaincus que l'avenir de l'IA d'entreprise passe par des modèles performants, contrôlables et déployables localement. L'ère des agents universels, capables d'automatiser des processus complexes, prend corps. Nous ne parlons plus seulement de chatbots, mais de systèmes intelligents qui interagissent avec les logiciels métiers, analysent des documents, et prennent des décisions autonomes. C'est une révolution qui est en marche, et nous sommes en première ligne.
Ce Que Nos Tests Révèlent et Nos Prochaines Étapes
Nos tests internes sur DeepSeek-V4.1-Flash-1017 confirment les gains de performance annoncés. Nous explorons activement comment intégrer ces avancées dans nos architectures multi-agents pour nos clients. L'objectif est clair : construire des solutions d'automatisation avancée qui sont non seulement puissantes, mais aussi résilientes et économiquement viables à long terme. Nous voyons les modèles open-source comme DeepSeek continuer à combler l'écart avec les modèles propriétaires, voire les dépasser sur certains aspects critiques comme la personnalisation et l'efficacité locale. L'agentique d'entreprise n'est plus une promesse lointaine, c'est une réalité opérationnelle que nous construisons chaque jour.
Besoin d'avancer sur ce sujet ?
Discutons de vos enjeux spécifiques lors d'un audit informel.
Lou Chardin
Head of Product
Conçoit les architectures de données et les OS métiers IA d'Astoïk. Passionné par l'intégration pratique de l'IA générative.
Profil LinkedIn