
Mistral Large 4 : Le Milliard de Paramètres Ouverts Qui Bouleverse l'Inférence Locale et l'IA d'Entreprise
L'annonce des poids complets de Mistral Large 4, prévue pour le 27 octobre, secoue le monde de l'IA. Avec plus d'un billion de paramètres, ce modèle européen promet de redéfinir l'inférence locale et la souveraineté numérique, tout en posant de nouveaux défis techniques pour nos architectures d'agents.
Le Déferlement Mistral Large 4 : Un Séisme pour l'Open Source
L'actualité brûlante de ces dernières 48 heures, celle qui fait vraiment vibrer nos serveurs et nos discussions d'architectes, c'est l'arrivée imminente des poids complets de Mistral Large 4. Mistral AI, le fleuron parisien, a dévoilé son nouveau mastodonte le 6 octobre 2026. Ce n'est pas une simple mise à jour. C'est un modèle à 1,05 billion de paramètres, entièrement entraîné dans leurs propres centres de données européens.
L'entreprise revendique le titre de « meilleur modèle ouvert au monde ». Une affirmation audacieuse, déjà en partie confirmée, en partie nuancée, par la firme de benchmarking indépendante Artificial Analysis. Nous sommes tous suspendus à la publication des poids complets, prévue pour le 27 octobre. Ce laps de temps, où le modèle est accessible en aperçu payant mais pas encore entièrement vérifiable par la communauté, génère une effervescence folle. C'est la course à l'armement IA, version européenne.
Ce n'est pas un événement isolé. Google, OpenAI, Anthropic et Mistral ont tous sorti une nouvelle génération de modèle en l'espace de deux semaines. La cadence s'accélère. Pour nous, chez Astoïk, ce genre de lancement redéfinit nos stratégies de déploiement et d'intégration. Nous regardons au-delà des benchmarks bruts. La question est : comment cette puissance brute se traduit-elle sur le terrain ?
Au-delà des Benchmarks : Ce Que Signifie 1 Billion de Paramètres en Pratique
Un modèle d'une telle envergure, c'est une promesse de capacités de raisonnement et de génération sans précédent pour un modèle open source. Nous avons vu les performances de modèles plus petits, comme DeepSeek-V4.1-Flash, transformer l'inférence locale. Mais 1,05 billion de paramètres, c'est une autre ligue. Cela implique des défis colossaux en termes de ressources de calcul.
Sur nos déploiements clients, nous gérons déjà des modèles de 70 milliards de paramètres sur des setups locaux, parfois même sur des ordinateurs portables bien équipés. Pour Mistral Large 4, l'optimisation sera la clé. Nous parlons de quantization avancée, de gestion du cache KV, et de l'exploitation maximale des architectures GPU modernes. La latence sera un facteur critique, surtout pour les applications agentiques qui demandent des interactions rapides.
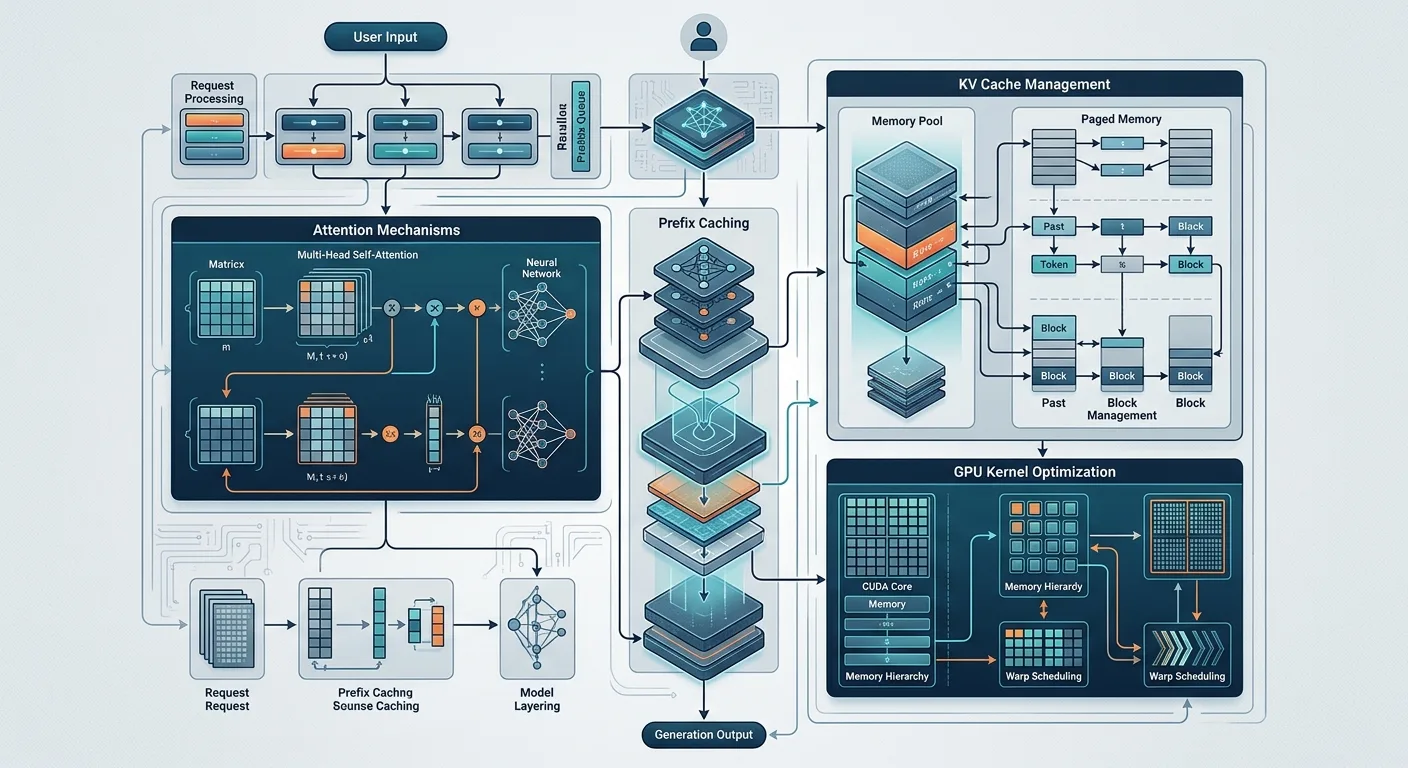
L'impact sur le coût est également central. Si nous pouvons faire tourner un tel modèle localement, même avec des compromis sur la précision ou la vitesse, cela réduit drastiquement notre dépendance aux APIs cloud propriétaires, et donc les coûts par token. C'est un argument de poids pour nos clients PME soucieux de leur budget et de la confidentialité de leurs données.
L'Inférence Locale Révolutionnée : vLLM et Ollama en Première Ligne
Pour apprivoiser un modèle comme Mistral Large 4 en local, les frameworks d'inférence jouent un rôle capital. Nous suivons de près les avancées de vLLM et Ollama. Leurs développeurs sont déjà en train d'adapter leurs architectures pour gérer des modèles toujours plus grands et plus complexes.
La feuille de route de vLLM pour le quatrième trimestre 2026, publiée le 10 octobre, met clairement l'accent sur les charges de travail agentiques et l'optimisation du service. Ils parlent de déploiement plus facile, de décodage spéculatif adaptatif et d'une meilleure tolérance aux pannes. Des points essentiels pour qu'un modèle d'un billion de paramètres puisse être exploitable hors des infrastructures hyperscale.
Ollama continue également d'évoluer à grande vitesse. Nous avons vu de nouvelles intégrations comme Clef, un modèle de décision multimodal, et Beam, conçu pour les tâches agentiques de longue durée. Ollama, c'est un peu le Docker de l'IA locale, simplifiant l'accès à des modèles comme Qwen3, Kimi K2.6 ou Gemma 4. Sa capacité à offrir une inférence privée, sans coût par token pour l'usage local, est un atout majeur.
Nous avons déjà partagé nos retours sur l'efficacité du triptyque Ollama, DeepSeek-V4.1-Flash et vLLM pour redéfinir l'inférence locale agentique. L'intégration de Mistral Large 4 dans cet écosystème sera un test décisif. Le défi est de maintenir un débit agentique élevé, même avec un modèle de cette taille. Les travaux sur les transferts KV bidirectionnels de vLLM, que nous avons analysés dans cet article, seront d'autant plus cruciaux.
Souveraineté et Compétition : Le Positionnement de Mistral AI
L'émergence de Mistral Large 4 est un signal fort pour la souveraineté numérique européenne. L'entreprise parisienne s'est positionnée comme un acteur clé face aux géants américains et chinois. Avoir un modèle d'une telle envergure, entraîné sur le continent, c'est une garantie de contrôle sur l'infrastructure et les données. C'est un enjeu stratégique que nous suivons attentivement.
Il faut dire que la compétition est féroce. Pendant que Mistral fait parler de lui avec Large 4, des rumeurs persistantes entourent DeepSeek V5, avec des spéculations sur un modèle à deux trillions de paramètres entraîné sur des puces Huawei. La course à la taille et à la performance est lancée, et chaque acteur tente de marquer son territoire.
OVHcloud a également annoncé son propre grand modèle de langage open source pour la fin novembre, promettant d'être « très en avance sur son temps ». Le paysage européen de l'IA est en pleine effervescence. Pour Astoïk, cela signifie plus d'options, mais aussi plus de complexité dans le choix des architectures. Notre rôle est d'évaluer ces modèles non seulement sur leurs performances brutes, mais aussi sur leur licence, leur support et leur pérennité pour des usages en entreprise.
Les Défis d'Intégration en Entreprise : Au-Delà de la Hype
Intégrer un modèle comme Mistral Large 4 dans nos architectures d'automatisation avancée, c'est une succession de défis pragmatiques. La taille du modèle, même quantifié, exigera une gestion fine de la mémoire VRAM. La latence, comme évoqué, est cruciale pour les boucles d'agents autonomes. Nous devons garantir que le temps de première token (TTFT) reste acceptable pour des interactions en temps réel.
Nous observons déjà les limites avec des modèles plus petits. Un modèle plus grand peut apporter une meilleure qualité de raisonnement et une compréhension contextuelle plus profonde, mais si chaque inférence prend plusieurs secondes, l'expérience utilisateur ou l'efficacité de l'agent en pâtit. C'est un arbitrage constant entre précision et vitesse.
L'orchestration multi-agents, où chaque agent pourrait s'appuyer sur une version optimisée de Mistral Large 4 pour des tâches spécifiques, devient un cas d'usage pertinent. Nous pensons à des systèmes où un agent principal distribue des requêtes à des agents spécialisés, chacun tirant parti des capacités de ce modèle géant. Cela ouvre de nouvelles voies pour l'automatisation complexe, notamment pour des tâches de codage ou d'analyse de documents longs. Les compétences (skills) des agents, comme celles que nous explorons avec les agents Gemini dans Google Workspace, pourraient être enrichies par la puissance de raisonnement de Mistral Large 4, à condition que l'inférence soit suffisamment rapide et fiable.
Perspectives et Prochaines Étapes pour Astoïk
La sortie des poids de Mistral Large 4 est un moment charnière. Dès le 27 octobre, nous allons mettre nos équipes sur le pont pour des tests approfondis. Il s'agira de quantifier les performances réelles sur nos infrastructures, d'évaluer les compromis de quantization et de mesurer l'impact sur le débit agentique. Nous sommes particulièrement intéressés par son comportement sur des tâches de raisonnement complexes et sa capacité à gérer de longs contextes.
Nous chercherons à intégrer Mistral Large 4 dans nos prototypes d'agents autonomes, en explorant les synergies avec des outils d'orchestration comme LangGraph ou AutoGen. Le but est de voir comment ce modèle peut enrichir les « skills » que nous développons pour nos clients, offrant des capacités décisionnelles plus fines et une meilleure compréhension des nuances métiers. La promesse d'une IA souveraine et performante, directement sur nos machines, est plus que jamais à portée de main. Mais comme toujours, le diable est dans les détails de l'implémentation.
Nous continuerons à partager nos retours terrain et nos analyses techniques. Le monde de l'IA ne cesse de nous surprendre, et notre mission est de transformer ces innovations en solutions concrètes et robustes pour nos clients.
Besoin d'avancer sur ce sujet ?
Discutons de vos enjeux spécifiques lors d'un audit informel.
Lou Chardin
Head of Product
Conçoit les architectures de données et les OS métiers IA d'Astoïk. Passionné par l'intégration pratique de l'IA générative.
Profil LinkedIn